- Mikrotjenester tillater utvikling av modulære og skalerbare applikasjoner, der hver tjeneste er autonom og kan distribueres uavhengig.
- Docker gjør det enkelt å lage lette, bærbare containere som pakker hver mikrotjeneste med alle dens avhengigheter.
- Kubernetes orkestrerer containerne, administrerer distribusjon, skalering, nettverksbygging og automatisk gjenoppretting av mikrotjenester i klyngen.
- Å bruke gode sikkerhets-, overvåkings- og automatiseringspraksiser er nøkkelen til å lykkes med å drive mikrotjenester i produksjon.
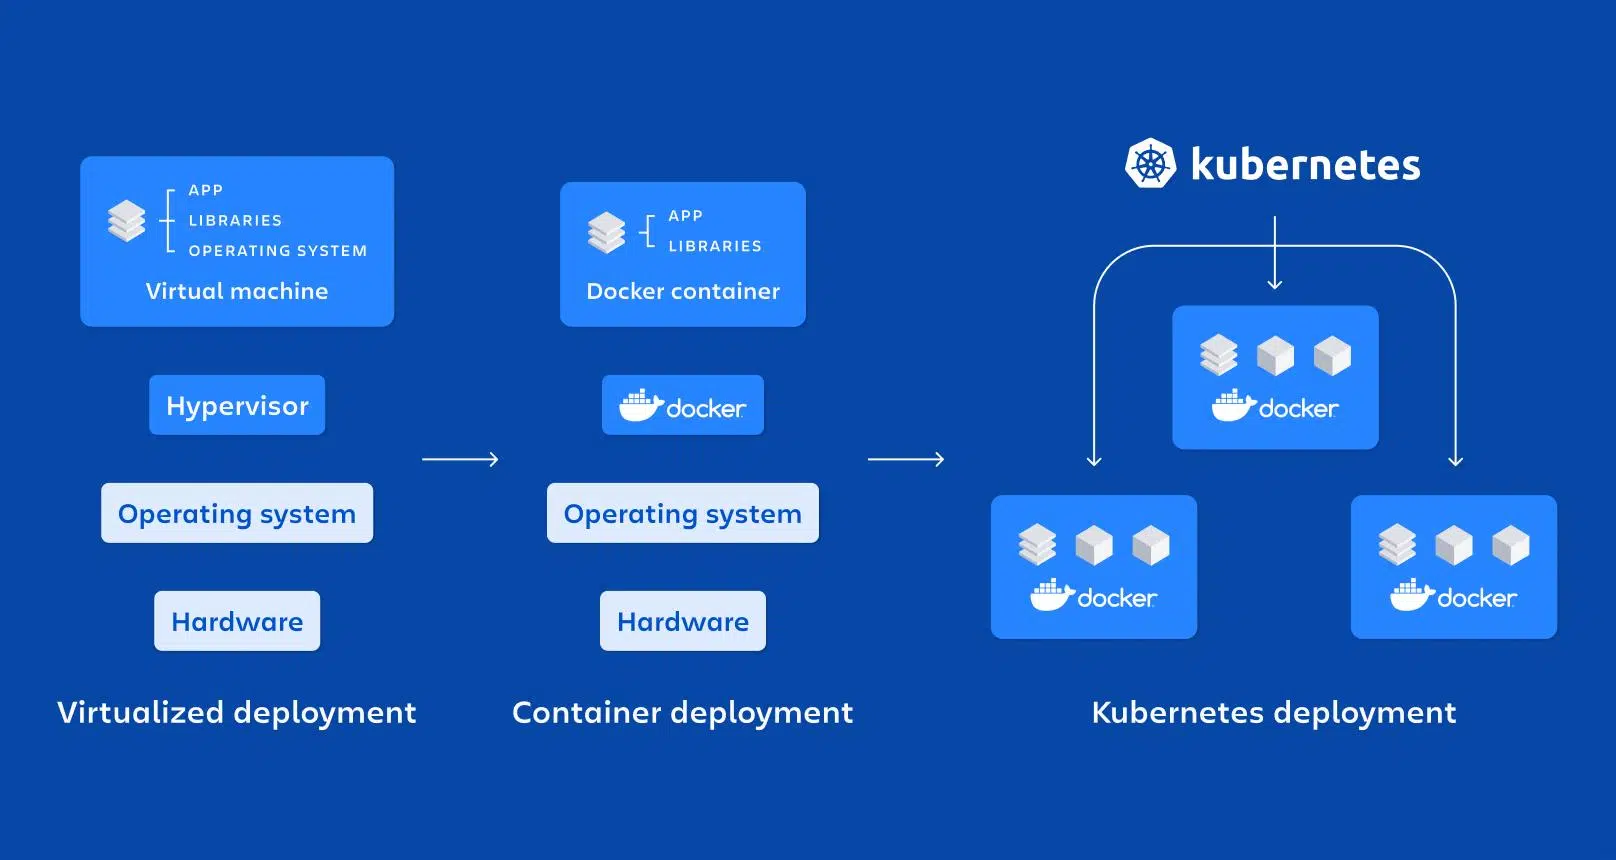
I de senere årene har kombinasjonen av mikrotjenester, Docker og Kubernetes blitt de facto-standarden for utrulling av moderne, skalerbare og vedlikeholdsvennlige applikasjoner. Flere og flere selskaper beveger seg bort fra monolittiske applikasjoner og omfavner distribuerte arkitekturer som er bedre egnet til skiftende miljøer og DevOps-strategier.
Hvis du lurer på hvordan du implementerer mikrotjenester med Docker og Kubernetes i praksis , vil dette innholdet være perfekt for deg: Vi gjennomgår nøkkelkonseptene, fordelene og utfordringene, hvordan du lager containere, hvordan du orkestrerer dem i en klynge, og hvilke trinn du skal følge for å installere dem på Windows og Linux , samt en rekke tips for å bruke dem klokt i virkelige miljøer.
Hva er en mikrotjenestearkitektur, og hvordan skiller den seg fra en monolitt?
En mikrotjenestearkitektur er basert på å dele en applikasjon inn i flere små, autonome og uavhengig utplasserbare tjenester , hver fokusert på en spesifikk funksjonalitet (brukere, betalinger, katalog, bestillinger osv.), som kommuniserer hovedsakelig gjennom lette API-er (HTTP/REST, gRPC, meldinger osv.).
I en monolittisk applikasjon, derimot, er all forretningslogikk, presentasjonslag og datatilgang pakket inn i én enkelt distribusjonsblokk ; enhver endring krever rekompilering, testing og distribusjon av hele systemet, noe som kompliserer utviklingen og øker risikoen for å introdusere feil i produksjonen.
Med mikrotjenester har hver tjeneste sin egen livssyklus: den kan utvikles, testes, distribueres, skaleres og versjoneres uavhengig . Dette lar flere team jobbe parallelt, forenkler adopsjonen av ny teknologi og legger til rette for integrering med CI/CD-praksiser.
Videre introduserer denne arkitekturen konseptet med komponentuavhengig skalerbarhet : i stedet for å skalere en hel monolittisk applikasjon for å støtte mer belastning på en bestemt modul, skaleres bare mikrotjenestene som virkelig trenger det, noe som optimaliserer infrastrukturressursene bedre.
Reelle fordeler og utfordringer med mikrotjenester
Å gå over til mikrotjenester er ikke bare en mote: det gir konkrete fordeler innen skalerbarhet, robusthet og distribusjonshastighet , men det introduserer også driftskompleksitet som må håndteres.
Blant de mest fremragende fordelene er den uavhengige skalerbarheten til hver tjeneste : hvis for eksempel betalingsmodulen mottar mer trafikk enn administrasjonsmodulen, kan du bare øke replikaene av betalingsmikrotjenesten, uten å berøre resten av applikasjonen eller sløse med ressurser.
Det er også betydelige gevinster ved kontinuerlig distribusjon og hyppige utgivelser . Ved å isolere hver tjeneste er det mulig å gi ut nye versjoner trinnvis, uten å måtte stoppe eller distribuere hele applikasjonen på nytt, noe som reduserer vedlikeholdsvinduer og forbedrer tiden det tar før de kommer på markedet.
Et annet viktig punkt er robusthet og feiltoleranse : når den er riktig utformet, bør ikke feil i én mikrotjeneste føre til at hele systemet faller ned. Med mønstre som tidsavbrudd, nye forsøk og sikringsbrytere kan de andre tjenestene fortsette å reagere, noe som begrenser virkningen av feil.
Videre gir mikrotjenester teknologisk fleksibilitet : hvert team kan velge det mest passende språket, rammeverket eller databasen for tjenesten sin, så lenge de respekterer kommunikasjonskontraktene og plattformens globale retningslinjer.
På den andre siden finner vi kompleksitet knyttet til operasjonell drift og observerbarhet . Å administrere dusinvis eller hundrevis av tjenester innebærer å håndtere distribuerte nettverk, sporing mellom tjenester, sentralisert logging, sikkerhet, API-versjonering og datakonsistens, noe som krever avanserte verktøy og modne prosesser.
Det blir også mer komplekst å håndtere kommunikasjon mellom tjenester : det er viktig å nøye utforme hvordan data utveksles, hvordan feil håndteres, hvordan latens styres, og hvordan man kan forhindre at en langsom avhengighet drar ned resten av systemet. Testing og feilsøking er ikke lenger trivielt, fordi du ikke tester en enkelt blokk, men et sett med sammenkoblede tjenester.
Containere: grunnlaget for å kjøre mikrotjenester isolert
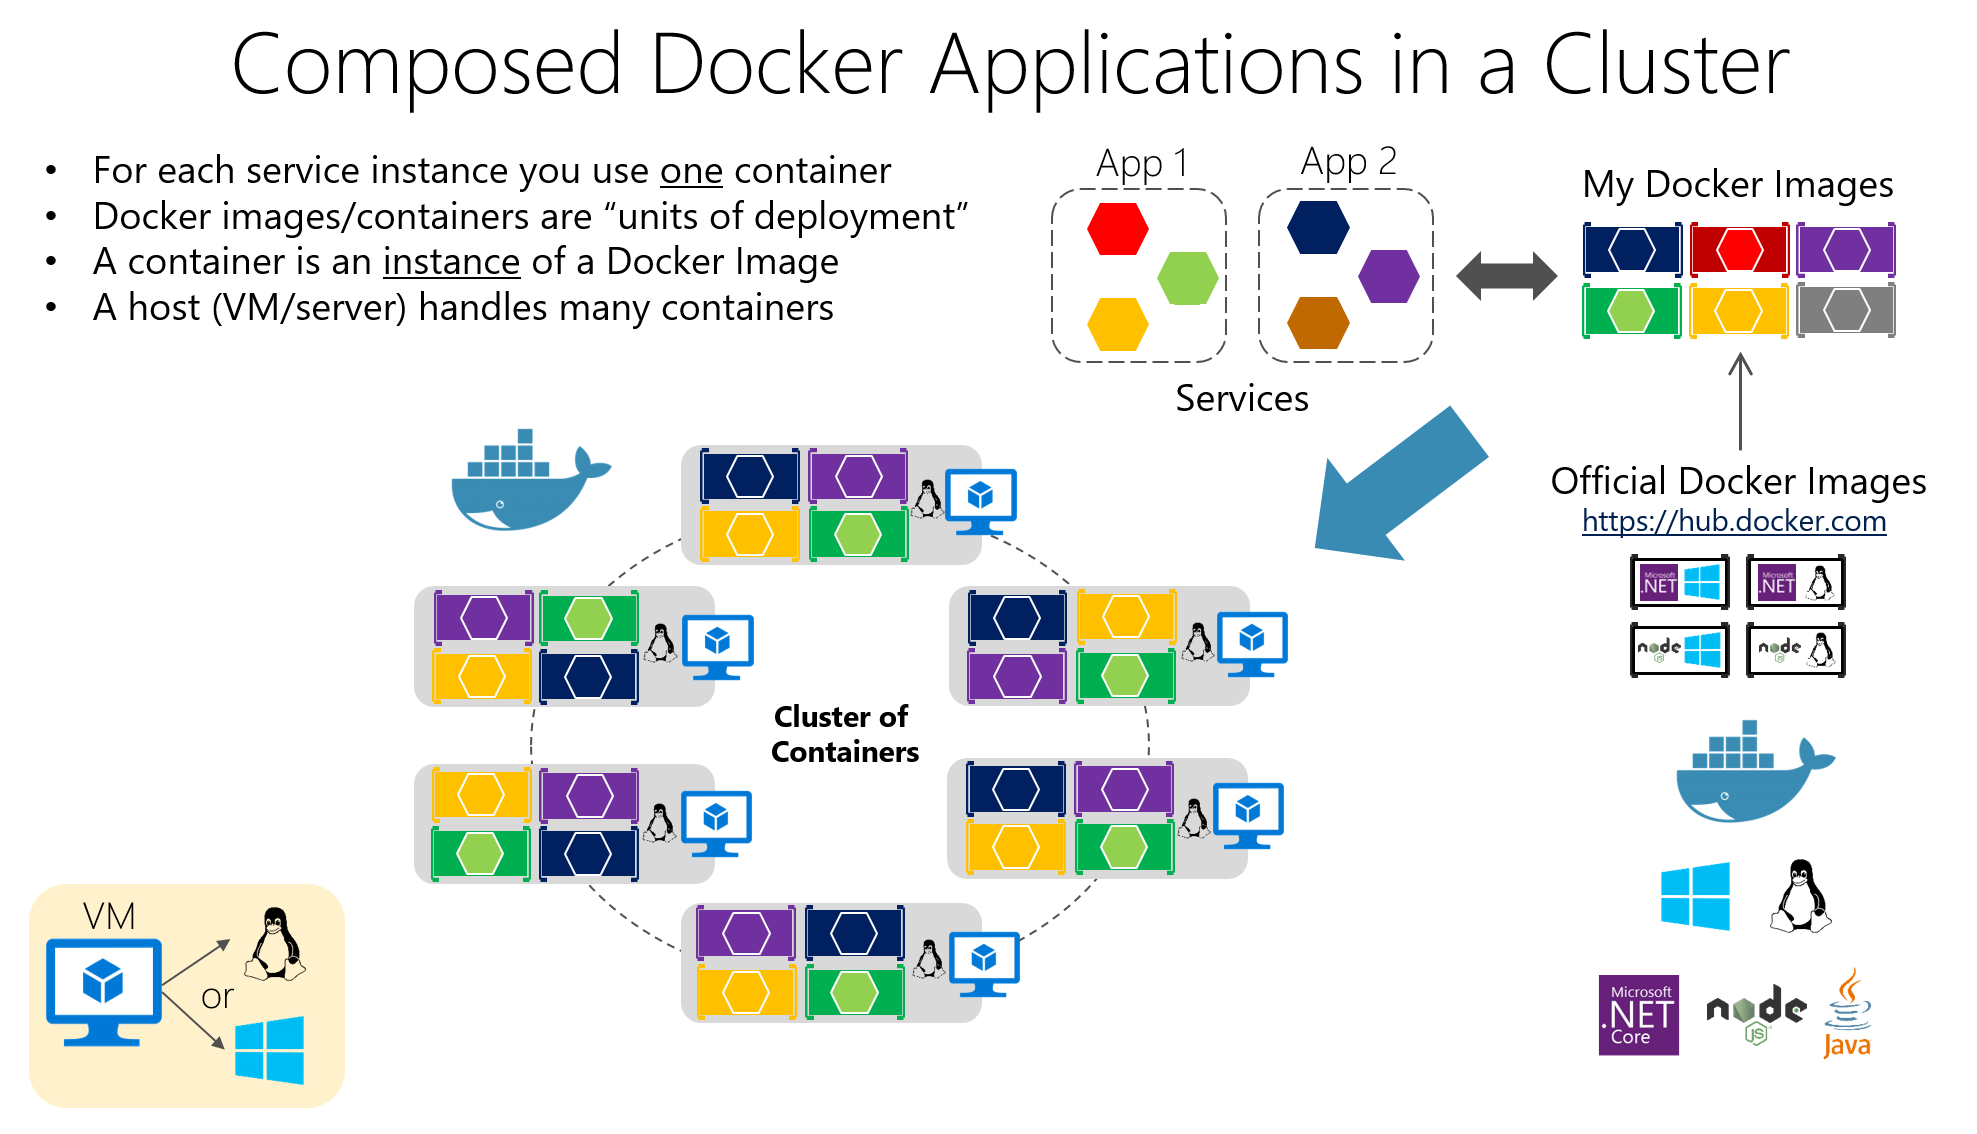
Containerteknologi har blitt den ideelle plattformen for mikrotjenester fordi den lar deg pakke en applikasjon og alle dens avhengigheter inn i en standardisert, bærbar enhet . I stedet for å installere biblioteker, kjøretider og verktøy på hver server, kjører alt i containeren.
En container er i hovedsak en lett form for virtualisering på operativsystemnivå : den deler vertskjernen, men kjører prosesser i isolerte navnerom og med ressurser begrenset av cgroups, noe som gjør at de starter opp raskt og bruker mindre enn en virtuell maskin.
Blant de viktigste egenskapene er isolasjon, portabilitet, letthet og modularitet ; hver mikrotjeneste som kjører i sin egen container blir enklere å distribuere, stoppe, oppdatere eller replikere, noe som passer perfekt til prinsippene for distribuerte arkitekturer.
Sammenlignet med virtuelle produksjonsmaskiner krever ikke containere et komplett operativsystem per instans ; i stedet deler de vertens operativsystem . Dette reduserer bildestørrelse og oppstartstid drastisk , slik at containere kan startes eller ødelegges på sekunder.
Docker: referanseplattformen for containerisering av mikrotjenester
Docker er det mest populære verktøyet for å jobbe med containere fordi det forenkler opprettelse, pakking, distribusjon og utførelse av containeriserte applikasjoner i utviklings-, test- og produksjonsmiljøer.
Kjerneideen er å pakke programvare inn i Docker-avbildninger , som er uforanderlige artefakter som inkluderer applikasjonskoden, bibliotekene den trenger, systemverktøy og grunnleggende konfigurasjoner. Fra disse avbildningene opprettes kjørende containere , som er isolerte instanser basert på det avbildningen.
Bildebygging er definert i en Dockerfile , en tekstfil som spesifiserer instruksjoner som basisbildet, arbeidskatalogen, hvilke filer som skal kopieres, hvilke avhengigheter som skal installeres, hvilke porter som skal eksponeres og hvilken kommando som skal kjøres når containeren startes.
Tenk deg at du har et API skrevet i Node.js. Du kan opprette en Dockerfile som ligner på følgende, og starte med et offisielt Node-bilde, kopiere filene, installere avhengighetene og definere oppstartskommandoen :
FROM node:14

WORKDIR /app

COPY . .

RUN npm install

EXPOSE 3000

CMD
Denne filen indikerer at applikasjonen vil kjøre i /app-katalogen inne i containeren , at avhengigheter vil bli installert med npm, at port 3000 vil bli eksponert, og at npm start vil bli utført når containeren starter.
For å bygge og starte den containeren, kjør ganske enkelt `docker build` fra prosjektmappen og deretter `docker run` , og kartlegg portene for å få tilgang til den fra verten, eller for applikasjoner med flere containere, bruk `docker-compose` :
docker build -t mi-app .

docker run -p 3000:3000 mi-app
Takket være denne modellen minimeres det klassiske problemet med at «det fungerer på min maskin» fordi kjøretidsmiljøet følger med applikasjonen. Videre integreres Docker sømløst med CI/CD-systemer, private registre og orkestreringsverktøy som Kubernetes.
Viktige komponenter i Docker og deres rolle i mikrotjenester
I en typisk utplassering snakker vi om en Docker Host , som er systemet (fysisk eller virtuelt) der Docker er installert; på den kjører Docker Engine , daemonen som administrerer bilder, nettverk, volumer og containerens livssyklus.
Containere inneholder applikasjonen og dens avhengigheter pakket i et image , slik at enhver server med Docker kan kjøre det imaget konsekvent. Denne konsistensen er avgjørende når du har mange mikrotjenester distribuert i forskjellige miljøer (utvikling, QA, produksjon osv.).
Blant de mest interessante fordelene med Docker er portabilitet mellom miljøer, distribusjonsautomatisering, prosessmodularitet og støtte for lag og versjonskontroll i bilder , noe som gjør det enklere å angre endringer og optimalisere lagring.
Kubernetes: orkestratoren for å styre hundrevis av containere
Når du går fra noen få containere til dusinvis eller hundrevis av dem, blir det et mareritt å administrere dem manuelt . Det er her Kubernetes kommer inn i bildet, en åpen kildekode-plattform designet for å orkestrere containere i stor skala.
Kubernetes automatiserer kritiske oppgaver som distribusjon, skalering, failover, nettverkskonfigurasjon og lagring av containeriserte applikasjoner. Den er designet for å kjøre i offentlige skyer, private skyer, hybridmiljøer og til og med lokale systemer.
Fokuset er på å administrere klynger som består av flere noder (maskiner) der containere kjører. Målet er å sikre at applikasjoner alltid er i ønsket tilstand : antall replikaer, distribuerte versjoner, tildelte ressurser og tilkobling mellom tjenester.
Grunnleggende elementer i Kubernetes
Den minste enheten i Kubernetes er Poden , som representerer en eller flere containerinstanser som må kjøres sammen (for eksempel en applikasjonscontainer og en sidecar-container for logging). Poder er flyktige: de opprettes, ødelegges og erstattes etter behov av klyngen.
For å eksponere podene dine tilbyr Kubernetes tjenesteressursen , som fungerer som et nettverksabstraksjonslag. En tjeneste grupperer et sett med poder og gir en stabil IP-adresse, et DNS-navn og intern lastbalansering , slik at klienter ikke trenger å vite detaljene for hver enkelt pod.
Distribusjonsressursen brukes til å definere hvordan poder skal distribueres og oppdateres: hvor mange replikaer, hvilket bilde som skal brukes, hvilke tagger som skal brukes og hvilken oppdateringsstrategi som skal følges. Kubernetes sørger for at ønsket antall poder alltid kjører og utfører rullerende oppdateringer eller tilbakestillinger når du endrer konfigurasjonen.
Det finnes også ressurser som ConfigMap og Secret , som lar deg eksternalisere konfigurasjon og lagre sensitive data (passord, tokens, API-nøkler) uten å måtte pakke dem inn i avbildningene. Dette forenkler sikker konfigurasjonsadministrasjon på tvers av ulike miljøer betraktelig.
Slik organiserer du en Kubernetes-klynge
"Hodet" til klyngen er Kubernetes Control Plane , som grupperer flere komponenter som er ansvarlige for å orkestrere hele systemet. Blant dem er API-serveren , som er porten for å administrere klyngen. Enhver handling (oppretting av en distribusjon, liste opp poder, endring av en tjeneste) går gjennom dette API-et.
Planleggeren er ansvarlig for å bestemme hvilken node hver Pod kjører, tatt hensyn til tilgjengelige ressurser, affiniteter og begrensninger; mens Controller Manager overvåker klyngens status og iverksetter handlinger for å sikre at virkeligheten samsvarer med det du har deklarert i manifestene (for eksempel å opprette nye Pods hvis det er færre enn du ba om).
Tilstandslagring delegeres til etcd , en distribuert database som lagrer konfigurasjon og informasjon for alle klyngeressurser. På den annen side kjører prosesser som kubelet (en agent som kobler noden til API-serveren), kube-proxy (som administrerer nettverkstrafikk og lastbalansering) og containerkjøretiden (Docker, containerd, CRI-O, osv.) på hver arbeidsnode.
Distribuere mikrotjenester i Kubernetes med YAML-filer
For å distribuere en mikrotjeneste i Kubernetes er vanlig praksis å beskrive den med et YAML-manifest , der du definerer distribusjonen (Pod-mal, bilde, porter, antall replikaer, etiketter) og den tilhørende tjenesten for å eksponere den i eller utenfor klyngen.
Et grunnleggende eksempel på distribusjon for et program kalt «min-app» kan se omtrent slik ut, der tre replikaer er definert og port 3000 er definert som containerporten:
apiVersion: apps/v1

kind: Deployment

metadata:

name: mi-app

spec:

replicas: 3

selector:

matchLabels:

app: mi-app

template:

metadata:

labels:

app: mi-app

spec:

containers:

- name: mi-app

image: mi-app:latest

ports:

- containerPort: 3000
Dette manifestet sier at klyngen må vedlikeholde tre kjørende Poder med «my-app:latest»-imaget, alle merket med app=my-app, slik at en tjeneste kan finne dem og fordele trafikk mellom dem. Kubernetes håndterer automatisk skalering, oppdateringer og Pod-utskifting ved feil.
Ved siden av distribusjoner er det vanlig å definere ClusterIP-, NodePort- eller LoadBalancer -tjenester , avhengig av om mikrotjenesten bare skal være tilgjengelig i klyngen, fra nodene eller fra internett. All denne konfigurasjonen er versjonert i repositorier og naturlig integrert med CI/CD-pipelines.
Skalering, oppgraderinger og selvreparasjon i Kubernetes
En av hovedgrunnene til å bruke Kubernetes er muligheten til å skalere og oppdatere mikrotjenester uten å stoppe applikasjonen . Du kan endre antall replikaer i manifestet (eller med en kubectl-kommando), og klyngen vil opprette eller slette pods til ønsket verdi er nådd.
Denne skaleringen kan være manuell eller automatisk, ved hjelp av ressurser som Horizontal Pod Autoscaler (HPA) , som dynamisk justerer replikaer basert på målinger som CPU eller minne. Dermed økes kapasiteten i perioder med høy etterspørsel, og ressurser frigjøres når belastningen avtar.
Når det gjelder oppdateringer, implementerer Kubernetes rullerende oppdateringer som standard: den oppretter Pods med den nye versjonen og fjerner gradvis de fra den forrige versjonen, uten plutselig avbrudd. Hvis noe går galt, lar en tilbakerulling deg raskt gjenopprette den forrige versjonen.
En annen kritisk funksjon er selvreparasjon : hvis en container eller Pod dør, gjenskaper Kubernetes den automatisk. Hvis en node slutter å svare, blir de berørte Podene omplanlagt på andre tilgjengelige noder, slik at applikasjonen holder seg operativ.
Overvåking og observerbarhet av mikrotjenester i Kubernetes
For å drifte et mikrotjenestemiljø effektivt er det ikke nok å bare distribuere og skalere: du trenger sanntidsinnsikt i tjenesteytelse og -tilstand . I Kubernetes er det vanlig å integrere verktøy som Prometheus for å samle inn målinger og Grafana for å visualisere dem.
Prometheus er ansvarlig for å «skrape» målinger fra Pods, noder og klyngekomponenter, lagre dem og la deg definere varsler om dem. Kombinert med Grafana kan du lage dashbord der du kan overvåke CPU-forbruk, minne, HTTP-feil, latenser, antall replikaer eller nodestatus på en veldig tydelig måte.
Videre tilbyr kubectl kommandoer for å inspisere statusen til distribusjoner, tjenester, poder og andre ressurser, vise logger , beskrive hendelser og få tilgang til containere for feilsøking. Alt dette er en del av en observerbarhetsstrategi som i mikrotjenester er viktig for trygghet.
Forholdet mellom mikrotjenester, Docker og Kubernetes
Mikrotjenester, Docker og Kubernetes passer sammen som brikker i samme puslespill: Mikrotjenestearkitekturen definerer hvordan du designer applikasjonen, Docker tar seg av pakking og kjøring av hver tjeneste, og Kubernetes orkestrerer alle disse containerne i en klynge.
Hver mikrotjeneste er innkapslet i et Docker-bilde som inkluderer koden og avhengighetene , noe som sikrer at den oppfører seg på samme måte på utviklerens bærbare datamaskin, i et testmiljø eller i skyproduksjon. Denne ensartede pakkingen er avgjørende for DevOps-filosofien.
Kubernetes fungerer på sin side som en containerorkestrator : den bestemmer hvor mange instanser av hver mikrotjeneste som skal kjøre, hvor de befinner seg, hvordan trafikken balanseres til dem, hvordan de gjenoppretter seg etter feil, og hvordan de skalerer når etterspørselen øker eller synker.
I en e-handelsapplikasjon kan du for eksempel ha mikrotjenester for autentisering, katalog, handlekurv og betalinger, hver med sitt eget Docker-image og Kubernetes-distribusjon. På denne måten kan du skalere katalogen for store kampanjer eller betalinger i kritiske perioder uten å påvirke resten av systemet , og orkestrere hele livssyklusen fra CI/CD-pipelines til etterproduksjonsovervåking.
Installere Docker og Kubernetes på Windows
Hvis du jobber med Windows, er den enkleste måten å starte på å installere Docker Desktop , som inkluderer Docker-motoren og tilleggsverktøy, og til og med alternativer for å aktivere Kubernetes integrert i maskinen din.
Den typiske prosessen innebærer å laste ned Docker Desktop fra det offisielle nettstedet , kjøre installasjonsprogrammet (Docker Desktop Installer.exe) og følge veiviseren. Under installasjonen kan du velge mellom å bruke Hyper-V eller WSL 2 som virtualiseringsteknologi. Hvis bare én av dem er tilgjengelig, er det den som vil bli brukt.
Etter at systemet har startet på nytt, initialiserer åpningen av Docker Desktop containermiljøet. Hvis virtualisering ikke var aktivert, tilbyr installasjonsprogrammet vanligvis å aktivere det automatisk . Derfra kan du starte containere, for eksempel Nginx eller dine egne applikasjoner.
For å bruke Kubernetes på Windows må du først ha Docker og virtualiseringsfunksjoner aktivert. Deretter kan du aktivere Kubernetes fra Docker Desktop eller installere og konfigurere kubectl til å administrere eksterne klynger og, om nødvendig, distribuere Kubernetes-dashbordet ved hjelp av et eksternt manifest.
Når den er konfigurert, kan du få tilgang til dashbordet via en lokal proxy, ved å bruke et autentiseringstoken generert med kubectl og peke for eksempel til .kube/config -konfigurasjonsfilen for å administrere tilgang til klyngen fra nettleseren.
Installere Docker og Kubernetes på Linux
På Linux-systemer, som Ubuntu, er det vanligvis ganske enkelt å installere Docker: du oppdaterer pakkene, installerer Docker-motoren og kontrollerer at miljøet fungerer som det skal ved å kjøre en testcontainer.
Typiske trinn inkluderer å oppdatere systemet med `apt-get update` og `apt-get upgrade` , fjerne eventuelle tidligere versjoner av Docker Desktop hvis de finnes, og deretter installere docker-ce, docker-ce-cli, containerd.io og docker-compose-pluginen fra de offisielle repositoriene eller ved å spesifisere ønsket versjon.
For å bekrefte at alt fungerer som det skal, startes vanligvis en «hello-world»-container, som laster ned og kjører et minimalt bilde . Hvis meldingen vises riktig, har du Docker oppe og kjører og er klar til å starte containerisering av mikrotjenestene dine.
Når det gjelder Kubernetes, kan det installeres på Linux ved hjelp av verktøy som kubeadm . Den typiske arbeidsflyten innebærer å legge til Kubernetes-repositorynøkkelen, konfigurere pakkelistefilen, installere kubeadm og sjekke versjonen.
Deretter initialiseres klyngen på masternoden med kubeadm init (som spesifiserer nettverksområdet for podene), kommandoen «join» hentes slik at arbeidsnodene blir med i klyngen, og lokal tilgang konfigureres ved å opprette $HOME/.kube- katalogen , kopiere admin.conf-filen og justere tillatelsene.
Med dette har du en grunnleggende klynge klar til å distribuere containeriserte mikrotjenester , installere et nettverk av Pods (Flannel, Calico, osv.) og begynne å jobbe med distribusjoner, tjenester og resten av Kubernetes-ressursene.
Beste praksis og anbefalinger for bruk av Docker og Kubernetes
For å få mest mulig ut av disse miljøene, anbefales det å følge en rekke beste praksiser med Docker, og starte med å bruke offisielle eller pålitelige bilder , enten fra Docker Hub eller fra verifiserte private arkiver, for å redusere sikkerhetsrisikoer.
Det anbefales på det sterkeste å optimalisere bildestørrelsen ved å bruke lette basisbilder, flertrinnsbygg og fjerne unødvendige midlertidige filer eller artefakter. Mindre bilder lastes ned raskere og øker hastigheten på Kubernetes-distribusjoner.
Et annet viktig poeng er å bruke volumer for datapersistens , i stedet for å lagre informasjon inne i containere, slik at tap eller gjenskaping av en container ikke innebærer tap av viktige data.
Å begrense ressursene som er tildelt hver container (CPU, minne, I/O) bidrar til å forhindre at én enkelt tjeneste monopoliserer verten og forringer de andre. I tillegg bør containere overvåkes med verktøy som Docker Stats eller mer avanserte løsninger for å opprettholde kontroll i produksjonen.
Med Kubernetes er det viktig å forstå klyngearkitekturen og dens komponenter før man går i produksjon. Dette reduserer mange problemer.
Det er også lurt å automatisere så mye som mulig : bruk replikeringskontrollere, autoskalere og jobber for batchopplastinger; dra nytte av rullerende oppdateringer og tilbakestillinger; og definer versjonerte deklarative manifester i Git-repositorier.
Sikkerhet må alltid være en topprioritet: begrense tilgang til API-serveren, administrere legitimasjon ved hjelp av hemmeligheter, kryptere data under overføring og i ro , bruke oppdateringer regelmessig og definere nettverkspolicyer som begrenser kommunikasjon mellom tjenester i henhold til prinsippet om minste privilegium.
Til slutt er det viktig å ha gode sentraliserte overvåkings- og loggføringssystemer , samt preproduksjonsmiljøer der endringer kan testes grundig før de distribueres til produksjonsklyngen, noe som reduserer risikoer og ubehagelige overraskelser.
Hele dette økosystemet av mikrotjenester, Docker-containere og Kubernetes-orkestrering lar deg bygge systemer som er mye mer fleksible, skalerbare og robuste enn tradisjonelle monolitter. Ved å kombinere en gjennomtenkt arkitektur, passende verktøy og beste praksis for DevOps, kan du distribuere applikasjoner som tilpasser seg sømløst til endringer i arbeidsmengden, gjenoppretter raskt fra feil og er enklere å utvikle over tid.


Lidenskapelig forfatter om verden av bytes og teknologi generelt. Jeg elsker å dele kunnskapen min gjennom å skrive, og det er det jeg skal gjøre i denne bloggen, vise deg alle de mest interessante tingene om dingser, programvare, maskinvare, teknologiske trender og mer. Målet mitt er å hjelpe deg med å navigere i den digitale verden på en enkel og underholdende måte.