- Isinasama ng MLflow ang lifecycle ng modelo ng ML sa pagsubaybay, mga proyekto, at pamamahala ng modelo.
- Ang isang matatag na deployment ay nangangailangan ng isang server, isang relational database, at isang artifact store.
- Ang pagsubaybay sa eksperimento ay nagbibigay-daan sa iyong ihambing ang mga pagtakbo, mga sesyon ng pagsasanay na paulit-ulit, at mga modelo ng bersyon.
- Ang MLflow ay maaaring i-integrate sa maraming framework at cloud, at maaaring palawakin gamit ang mga plugin at REST API.

Kung mahilig ka sa paggawa ng mga data model ngunit nahihirapan kang panatilihing organisado ang iyong mga eksperimento sa machine learning , napunta ka sa tamang lugar. Habang lumalaki ang mga proyekto, ang pagsubok sa mga pagkakaiba-iba ng modelo, preprocessing, hyperparameter, at mga dataset ay maaaring maging magulo kung walang tool para mapanatiling maayos ang lahat.
Dito pumapasok ang MLflow bilang pangunahing bahagi ng MLOps : isang open-source platform na tumutulong sa iyong kontrolin ang buong lifecycle ng iyong mga modelo, mula sa mga unang eksperimento hanggang sa production deployment. Sa tutorial na ito ng MLflow, matututunan mo, hakbang-hakbang, kung ano ito, kung paano ito i-install sa isang server, kung paano i-integrate ang isang database at artifact storage, kung paano irehistro ang iyong mga eksperimento, at kung paano i-publish ang mga modelo bilang mga ready-to-use na API.
Ano ang MLflow at bakit ito madalas gamitin sa mga MLOp?
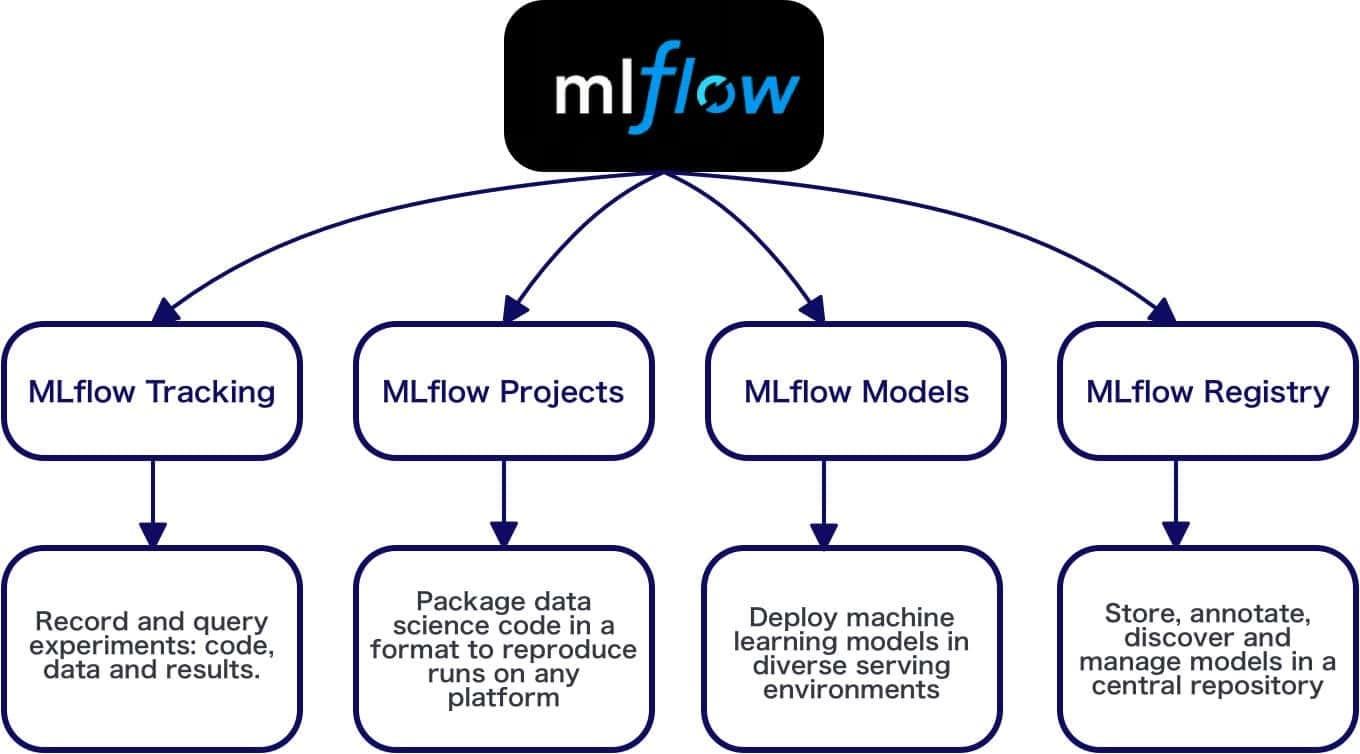
Ang MLflow ay isang open-source na tool para sa pamamahala ng lifecycle ng mga machine learning model , na lubos na nakatuon sa paglutas ng mga karaniwang problema ng pagkakaroon ng maraming eksperimento, maraming bersyon ng mga modelo, at iba't ibang execution environment.
Ang plataporma ay umaasa sa ilang mahahalagang bahagi na maaari mong gamitin nang magkasama o magkahiwalay depende sa iyong mga pangangailangan, nang hindi kinakailangang gamitin ang buong stack nang sabay-sabay, na ginagawang napaka-flexible at ecosystem-agnostic ang MLflow.
Mga pangunahing bahagi ng MLflow
Sa loob ng MLflow, mayroong ilang mga modyul na idinisenyo upang tugunan ang mga partikular na problema sa pagbuo ng modelo, bawat isa ay may sariling API at paraan ng pagtatrabaho, ngunit lahat ay isinama sa ilalim ng iisang interface ng pagsubaybay.
- Pagsubaybay: namamahala sa mga parameter ng tala, mga sukatan, mga artifact, at mga modelo sa bawat pagtakbo ng pagsasanay, para madali mong maihahambing ang iba't ibang pagtakbo sa loob ng isang eksperimento.
- Proyekto: Pinapayagan nito i-package ang code at mga dependency ng isang proyektong ML upang gawin itong maaaring kopyahin, nang sa gayon ay mapatakbo ng ibang tao (o ng iyong sarili sa hinaharap) ang eksaktong parehong daloy.
- Modellen: namamahala sa pagbersyon, pagpaparehistro at pag-deploy ng mga modelo sa iba't ibang format at destinasyon, kabilang ang mga custom na HTTP endpoint, integrasyon sa mga serbisyo ng cloud tulad ng Azure ML o AWS SageMaker, at pag-export para sa mga kapaligiran tulad ng Apache Spark.
Isang interesanteng detalye ay hindi mo obligado na gamitin ang lahat ng module . Ang ilang team ay gumagamit lamang ng Tracking at Models, kaya hindi na kailangan ng Projects dahil ang kanilang workflow ay humahawak na sa packaging gamit ang Docker o mga katulad na tool. Ang maganda sa MLflow ay medyo maayos itong umaangkop sa iba't ibang paraan ng pagtatrabaho.
Bukod pa rito, ang MLflow ay hindi nakatali sa iisang database o file system: maaari mong pagsamahin ang iba't ibang storage backend (MySQL, PostgreSQL, SQLite, S3, Google Cloud Storage, atbp.) at mag-deploy ng mga modelo kapwa sa server mismo at sa mga external platform.
Mga kinakailangan para sa pag-set up ng MLflow server sa produksyon
Bago ka magsimulang mag-log ng mga modelo na parang wala nang bukas, kailangan mo munang magkaroon ng maayos na na-configure na MLflow server . Hindi ito kumplikado, ngunit may ilang bahagi na kailangang pagtugmain: isang virtual machine, isang database, imbakan ng artifact, at ilang mga panuntunan sa network.
Sa pagsasagawa, ang karaniwang pag-deploy ng MLflow sa isang kapaligirang pangkoponan ay batay sa tatlong pangunahing elemento na dapat paghiwalayin hangga't maaari upang matiyak na ito ay maaaring i-scale at mapanatili.
1. Virtual machine o server kung saan patatakbuhin ang MLflow
Ang unang hakbang ay ang pagkakaroon ng virtual machine o server kung saan tatakbo ang proseso ng MLflow, ang web interface nito, at opsyonal, ang mga model endpoint. Magagawa mo ito on-premises o sa cloud; isang karaniwang halimbawa ay ang paggamit ng isang maliit na instance sa Google Cloud, AWS, o Azure.
Halimbawa, sa Google Cloud, maaari kang lumikha ng VM mula sa Compute Engine , kahit na gamit ang mga napakagaan na uri tulad ng libreng e2-micro para sa mga testing environment. Pagkatapos malikha ang instance, kumokonekta ka sa pamamagitan ng SSH mula sa console ng provider at nasa loob ka na ng system para mag-install ng mga dependency.
2. Database para sa pagsubaybay sa metadata
Ang MLflow server ay nangangailangan ng database upang mag-imbak ng impormasyon sa pagsubaybay : mga parameter, sukatan, mga sanggunian ng artifact, impormasyon ng pagpapatakbo, atbp. Sinusuportahan ng MLflow ang ilang mga backend, ngunit sa mga seryosong kapaligiran, ang mga sumusunod ay karaniwang ginagamit:
- PostgreSQL
- MySQL
- SQLite (inirerekomenda lamang para sa pagsubok o lokal na paggamit)
Sa maraming deployment, ang database ay naka-install sa parehong virtual machine gaya ng MLflow server para sa pagiging simple, bagama't para sa mga seryosong proyekto, kadalasan ay mas mainam na magkaroon ng database bilang isang pinamamahalaang serbisyo o sa isang hiwalay na server, para sa performance at seguridad.
3. Pag-iimbak ng mga artifact (mga modelo, datos, grapiko…)
Bukod sa metadata, kailangan din ng MLflow ng isang artifact repository para iimbak ang lahat ng bagay na hindi isang parameter o metric: mga serialized model, data file, graph, report, atbp. Maaari mong gamitin ang sariling disk ng VM, ngunit sa production, mas karaniwan ang paggamit ng data lake tulad nito:
- Amazon S3
- Google Cloud Storage
- Imbakan ng Azure Blob
Sa isang halimbawa tungkol sa Google Cloud, ang pinakanatural na gawin ay ang lumikha ng isang Balde ng Imbakan sa Cloud nakalaan para sa MLflow at ginagamit ang URI nito (halimbawa, gs://nombre_del_bucket) bilang lokasyon ng mga artifact ng server at client.
Hakbang-hakbang na pag-install ng MLflow sa isang virtual machine
Kapag nagawa mo na ang VM at na-access na ito sa pamamagitan ng SSH, ang susunod na hakbang ay ang pag-install ng MLflow at mga dependency nito . Kadalasan, mas maginhawang magtrabaho sa mga nakahiwalay na kapaligiran, halimbawa, gamit ang Conda o Miniconda, upang maiwasan ang pagkalat sa pandaigdigang sistema.
Sa isang karaniwang sesyon, ida-download at i-install mo ang Miniconda , tatanggapin ang lisensya, at idadagdag ang Conda sa iyong PATH. Pagkatapos, ia-activate mo ang base environment o lilikha ng bago para sa MLflow, kung saan mo ii-install ang main library at, kung gusto mo, lahat ng kapaki-pakinabang na extra.
I-install ang MLflow nang mayroon o walang mga extra
Maaaring i-install ang MLflow sa dalawang pangunahing paraan, gamit ang alinman sa pip o conda , depende sa kung gusto mo ng minimal o mas kumpletong instalasyon:
- Pag-install na may mga extra: Kasama ang MLflow kasama ang mga integrasyon para sa mga aklatan at tagapagbigay ng serbisyo napakakaraniwan (scikit-learn, Azure, AWS, atbp.), na siyang nakakaiwas sa unti-unting pag-install ng mga karagdagang pakete.
- Pangunahing pag-install: i-install lang "Pinagbawalan" ang mlflow at manu-mano mong idinaragdag ang mga dependency na kailangan mo (mga ML framework, cloud connector, atbp.).
Kung nagse-set up ka ng test environment o shared environment para sa team, kadalasang sulit na i-install ang MLflow na may mga extra para hindi mo masayang ang oras mo sa mga dependency na halos tiyak na gagamitin mo.
I-configure ang firewall at mga access port
Para makita ang MLflow web UI at mailantad ang mga modelo bilang mga HTTP endpoint, kailangan mong buksan ang mga naaangkop na port sa firewall ng iyong imprastraktura. Sa isang halimbawang pag-deploy ng GCP, maaari kang lumikha ng isang firewall rule na may katulad na:
- Destinasyon ayon sa mga label (halimbawa, ang label ng network ng VM, uri) mlflow).
- Pinagmulan: hanay ng mga IP na magkakaroon ng access; para sa mabilisang mga pagsubok, karaniwang ginagamit ito 0.0.0.0/0bagama't sa produksyon ay mas mainam na paghigpitan ito.
- Mga bukas na TCP port: halimbawa, 8080 para sa UI at iba pa tulad ng O 8081 1234 para sa mga naka-deploy na modelo.
Kapag nagawa na ang panuntunan, maaari mo nang ilunsad ang MLflow server sa VM at i-access ito mula sa iyong browser gamit ang panlabas na IP address ng makina at itinalagang portisang bagay tulad ng XX.XXX.XXX.XXX:8080, kung saan makikita mo ang interface ng pagsubaybay.
Pagkonekta ng MLflow sa isang relational database
Para lumampas sa mga local file backend at makamit ang isang matatag na kapaligiran, mahalagang i-configure ang isang relational database bilang tracking backend . Nagbibigay-daan ito sa iba't ibang user at machine na magsulat at magbasa mula sa iisang pinagmumulan ng katotohanan.
Isang karaniwang pattern ang paggamit ng PostgreSQL na naka-install sa mismong VM (para sa mga simpleng kapaligiran) o isang panlabas na pinamamahalaang instance (para sa mga senaryo na may mas mataas na load o seryosong produksyon).
Gumawa ng MLflow database at user
Ang karaniwang pagkakasunod-sunod para sa paghahanda ng backend sa PostgreSQL ay binubuo ng:
- I-install ang server PostgreSQL sa makina (o kumonekta sa isang umiiral na makina).
- Gumawa ng bagong database na gagamitin mo bilang Tindahan ng metadata ng MLflow.
- Magtakda ng partikular na username at password para sa MLflow at bigyan ito ng mga pahintulot sa database na iyon.
Kapag nalikha na ang database, gagamitin ito ng MLflow upang iimbak ang lahat ng impormasyon tungkol sa mga eksperimento, pagpapatupad, rehistradong modelo at LoggedModels (ang entity na ipinakilala sa MLflow 3 na nag-aangat sa mga modelong nabuo ng mga pagpapatupad sa unang antas sa loob ng lifecycle).
I-install ang mga database connector para sa MLflow
Para makipag-ugnayan ang MLflow sa PostgreSQL, kailangan mong i-install ang kaukulang konektor, tulad ng psycopg2 o psycopg2-binary sa Python. Kung wala ang package na ito, hindi makakakonekta ang MLflow server sa database o makakagawa ng mga kinakailangang talahanayan.
Kapag naka-install na ang konektor, ang configuration ay magiging pagbigay na lamang ng connection URI sa pagsisimula ng server, sa ganitong format:
postgresql://usuario:password@host/basededatos
Mula roon, lahat ng mga pagpapatupad, parameter, at sukatan na iyong itatala ay isesentralisa sa database na iyon, handa nang i-query mula sa parehong UI at sa mga high- at low-level na API.
I-configure ang imbakan ng artifact gamit ang data lake
Bukod sa database, kailangan din ng MLflow ng lokasyon para mag-imbak ng mga artifact: mga modelo, dataset, graph, karagdagang log , atbp. Ang mga file na ito ay maaaring lumaki nang malaki, kaya makatuwiran na umasa sa isang scalable storage system.
Sa mga cloud environment, isang napaka-maginhawang opsyon ang paggamit ng bucket sa Cloud Storage (GCP), S3 (AWS) o mga katumbas na serbisyo , na nauunawaan ng MLflow nang natively sa pamamagitan ng mga partikular na URI.
Paggawa ng Cloud Storage bucket para sa MLflow
Sa Google Cloud, ang karaniwang pamamaraan para sa paggamit ng bucket bilang isang artifact repository ay:
- Pumunta sa Cloud Storage at gumawa ng bagong balde na may kakaibang pangalan.
- Piliin ang uri at rehiyon ng imbakan ayon sa iyong mga pangangailangan.
- Kopyahin ang gsutil URI, parang
gs://nombre_del_bucketna siyang gagamitin mo sa configuration ng MLflow.
Ang URI na iyon ang magiging base path kung saan itatago ng MLflow ang lahat ng artifact na nauugnay sa mga pagpapatupad, na naka-grupo ayon sa eksperimento at pagpapatakbo.
Magbigay ng mga pahintulot sa VM service account
Para makapagbasa at makapagsulat ang server sa bucket na iyon, dapat ibigay ang mga pahintulot sa service account na ginagamit ng VM. Karaniwang ginagawa ito mula sa seksyon ng IAM ng proyekto:
- Mahahanap mo ang account ng serbisyo ng Compute Engine, sa format na [protektado ng email].
- Pumunta sa tab na mga pahintulot ng bucket at idagdag ang account ng serbisyong iyon bilang isang miyembro.
- Bibigyan mo siya ng angkop na papel, halimbawa Admin ng Bagay sa Imbakan, para payagan kang lumikha at maka-access ng mga artifact.
Gamit ito, ang MLflow server, na tumatakbo sa loob ng VM at gumagamit ng service account na iyon, ay makakapag-ugnayan nang walang putol sa bucket sa background.
Mga pahintulot para sa server at para sa client
Sa panig ng server, kung ang VM at ang bucket ay nasa iisang proyekto, karaniwang wala nang ibang kailangan. Sa panig ng client (iyong laptop o ibang panlabas na makina), karaniwang kailangan mong i-configure ang mga kredensyal upang direktang mag-upload ng mga artifact.
Sa kaso ng GCP, ang karaniwang daloy ng trabaho ay ang pag-download ng JSON file na naglalaman ng mga service account key mula sa IAM console, i-save ito sa iyong lokal na proyekto, at gumamit ng mga library tulad ng mga mula sa Google Cloud Storage upang mag-authenticate bago magsulat ng anumang artifact. Gagamitin ng mga client na nagpapatakbo ng code gamit ang MLflow ang mga credential na ito upang ma-access ang bucket, tulad ng ginagawa ng server.
Paglulunsad ng MLflow server gamit ang isang remote backend
Kapag mayroon ka nang tatlong sangkap (host/port, database URI, at artifact path), ang natitira na lang ay simulan ang MLflow server gamit ang mga parameter na iyon . Ang karaniwang gawain ay patakbuhin ang server command na tahasang tumutukoy sa:
- Ang host na nakikinig, halimbawa 0.0.0.0 para tumanggap ng mga panlabas na koneksyon.
- Ang UI port, halimbawa 8080.
- Ang URI ng relational database.
- Ang URI ng imbakan ng artifact, halimbawa gs://pangalan_ng_bucket.
Habang tumatakbo ang server, kung bubuksan mo ang iyong browser at pupunta sa na-configure na pampublikong IP address at port, makikita mo ang MLflow tracking interface at maaari ka nang magsimulang lumikha ng mga eksperimento, magpatakbo ng mga pagsubok, at mag-log ng mga modelo . Dito nagsisimula ang kasiyahan: paggamit ng instrumento sa iyong code at paggamit ng tracking.
Paano gamitin ang MLflow Tracking para isaayos ang iyong mga eksperimento
Ang Tracking module ay marahil ang pinakaginagamit na bahagi ng MLflow dahil nalulutas nito ang isang totoong problema: ang pag-alam nang eksakto kung ano ang iyong sinubukan, gamit ang anong configuration, at ano ang resulta . Kung wala ito, ang pag-iterate sa mga kumplikadong modelo ay nagiging isang malaking loterya.
Simple lang ang pinagbabatayang ideya: sa bawat oras na magsanay ka ng isang modelo, magbubukas ka ng isang run, itatala ang mga parameter, sukatan, artifact at ang modelo mismo, at iiwan ang lahat ng iyon na nakasentro sa server upang maihambing mo ito sa ibang pagkakataon sa pamamagitan ng biswal o programming.
Mga pangunahing konsepto: mga eksperimento, pagpapatupad, at mga modelo
Isinasaayos ng MLflow ang impormasyon sa pagsubaybay batay sa tatlong pangunahing entidad na dapat mong maunawaan mula sa simula:
- Mga eksperimentoPinagsasama-sama nila ang isang hanay ng mga magkakaugnay na pagpapatupad. Kadalasan, mayroong isang eksperimento sa bawat proyekto o problema sa negosyo (halimbawa, "Hula sa churn ng customer").
- Mga Tumatakbo: kumakatawan sa isang konkretong pagpapatupad ng iyong codena may partikular na configuration at data. Ang bawat run ay may kanya-kanyang ID, oras ng pagsisimula, tagal, at status (tagumpay o pagkabigo).
- Mga Modelo / Mga Naka-log na Modelo: ay ang mga sinanay na artifact ng modelo na nalilikha habang isinasagawa ang mga execution. Simula noong MLflow 3, itinataas sila ng LoggedModels sa isang first-level entity upang subaybayan ang kanilang lifecycle nang lampas sa isang run lamang.
Habang tumatakbo, maaari kang magtala ng iba't ibang uri ng impormasyon gamit ang Tracking API, alinman sa pamamagitan ng mga awtomatikong ruta (autolog) o manu-mano, na nagbibigay sa iyo ng napakapinong kontrol sa kung ano ang gusto mong i-save.
Ikonekta ang kliyente sa MLflow server
Bago mag-log ng kahit ano, dapat na nakaturo ang iyong script o notebook sa tamang tracking server . Ginagawa ito sa pamamagitan ng pag-configure ng tracking URI sa iyong code, halimbawa gamit ang Python:
mlflow.set_tracking_uri("http://IP_DEL_SERVIDOR:8080")
Mula sa puntong iyon, lahat ng iyong ilo-log ay mapupunta sa server na iyon, maliban na lang kung babaguhin mo ang URI. Bukod pa rito, maaari mong tahasang tukuyin kung aling eksperimento ang ilo-log ang mga pagpapatupad gamit ang mlflow.set_experiment o mga katulad na function.
Gumawa o pumili ng eksperimento
Para maiwasang mauwi ang iyong mga pagpapatakbo sa isang generic na eksperimento o isa mula sa default na notebook (sa mga platform tulad ng Databricks), mainam na gumawa ng sarili mong eksperimento o muling gamitin ang isang umiiral na eksperimento. Magagawa mo ito mula sa UI o mula sa code.
Sa Python API, mayroong isang utos na, kung bibigyan ng pangalan ng eksperimento, ay lilikha nito kung hindi ito umiiral o pipiliin ito bilang aktibo kung umiiral na ito, na nagreresulta sa Napakadaling gamitin para sa pag-automate ng iyong mga notebook o scriptBagama't mayroon ding pamamaraan ang MLflow create_experiment()Ang pamamaraang pinagsasama ang paglikha at pagpili ay karaniwang nagdudulot ng mas kaunting abala.
Simulan at isara nang tama ang mga pagpapatupad
Para malaman ng MLflow kung aling run ang iuugnay sa mga parameter at metric, kailangan mong simulan ang isang execution gamit ang `start_run` . Ang pinakamalinis na paraan ay ang paggamit nito sa loob ng isang Python context manager.
with mlflow.start_run(run_name="nombre_run"):

    # aquí entrenas el modelo y haces los logs
Ang bentahe ng pattern na ito ay ang MLflow Awtomatiko nitong isinasara ang pagpapatupad paglabas sa block, kahit na may mga error. Bilang kahalili, maaari mong manu-manong kontrolin ang lifecycle gamit ang start_run() y end_run()Pero mas madaling kalimutang isara ang mga ganoong run.
Ano ang maaaring itala sa isang pagtakbo
Sa loob ng isang run, maaari kang mag-log ng iba't ibang uri ng impormasyon na ipapakita ng MLflow na nakaayos sa interface at maaari ka ring mag-query sa pamamagitan ng API:
- ParameterIto ay karaniwang mga hyperparameter o mga halaga ng configuration na iyong itinatakda (bilang ng mga puno, uri ng solver, laki ng batch, atbp.). Ang mga ito ay nakarehistro sa
mlflow.log_paramolog_params. - Mga MetricsIto ay mga numerikal na resulta ng pagsasanay o ebalwasyon (katumpakan, AUC, RMSE, pagkawala, atbp.). Ang mga ito ay itinatala gamit ang
mlflow.log_metric, at maaaring ma-update nang maraming beses para sa parehong sukatan sa paglipas ng panahon. - Mga artifactAnumang file na gusto mong iugnay sa pagpapatakbo: mga dataset, graph, ulat, notebook, atbp. Ang mga ito ay ina-upload gamit ang
mlflow.log_artifactolog_artifacts. - Mga modelo: ang mismong sinanay na modelo, na nakarehistro gamit ang mga partikular na API ng bawat balangkas, tulad ng
mlflow.sklearn.log_model,mlflow.xgboost.log_model, Atbp
Isang napakalakas na tampok ang autolog : para sa ilang partikular na framework (scikit-learn, TensorFlow, Keras, XGBoost, LightGBM, PyTorch, Fastai, Statsmodels, Spark, H2O, Transformers, atbp.) awtomatikong mai-log ng MLflow ang malaking bahagi ng mga parameter at metrics nang hindi mo na kailangang tawagin ang mga ito isa-isa.
Mga praktikal na halimbawa ng pagsubaybay gamit ang MLflow
Para makita ang pagsubaybay sa aksyon, maaari mong gamitin ang mga klasikong dataset tulad ng Iris o Titanic at sanayin ang mga simpleng modelo gamit ang scikit-learn. Ang susi ay hindi ang pagiging kumplikado ng modelo kundi ang disiplina ng pagtatala ng iyong ginagawa.
Halimbawa, maaari kang mag-set up ng isang flow kung saan mo ilalagay ang mga nawawalang value (mean para sa edad, mode para sa mga categorical variable), aalisin ang mga hindi kaugnay na column, hatiin sa train/test, at sanayin ang isang Logistic Regression o Random Forest model na may cross-validation , na sine-save ang bawat kumbinasyon ng mga hyperparameter bilang isang hiwalay na run.
Pagre-record ng maraming run na may iba't ibang hyperparameter
Isipin mong gusto mong subukan ang iba't ibang configuration ng isang classification model: babaguhin mo ang solver, ang value ng C, at ang maximum na bilang ng mga iteration sa isang Logistic Regression. Para sa bawat kombinasyon, gagawin mo ang sumusunod sa loob ng isang run:
- Irerehistro mo ang mga hyperparameter gamit ang log_param.
- Kinakalkula mo ang mga sukatan ng pagsusuri (hal., katumpakan sa test suite) at sine-save ang mga ito gamit ang log_metric.
- Iserialize mo ang modelo sa isang file
.pklat i-upload ito bilang isang artifact o, mas mabuti pa, Ginagamit mo ang MLflow model API para i-log ito.
Sa UI, makakakita ka ng isang talahanayan ng mga pagpapatupad kung saan ang bawat hilera ay isang pagpapatakbo, kasama ang mga parameter, sukatan, at isang tagapagpahiwatig kung ito ay matagumpay. Matagumpay na natapos ang pagpapatupad o may mga errorMaaari ka ring magtalaga ng mas naglalarawang mga pangalan sa mga tumatakbo gamit ang parameter na run_name, isang bagay na lubos na inirerekomenda para hindi mo makaligtaan.
Ang pag-click sa alinman sa mga pagpapatupad ay magdadala sa iyo sa isang detalyadong view kung saan ipinapakita ng MLflow ang:
- Los mga naitalang parametro at ang halaga nito.
- ang sukatan, kasama na ang ebolusyon nito sa paglipas ng panahon kung nakapag-log in ka na ng ilang update.
- Los mga kalakip na artifact, gaya ng serialized model, mga graph, o mga dataset.
Mula sa view ng eksperimento, maaari kang pumili ng maraming run at paghambingin ang mga ito, i-filter ang mga ito ayon sa mga saklaw ng sukatan o mga halaga ng parameter, at bumuo ng mga graph na makakatulong sa iyong maunawaan kung aling mga kumbinasyon ang pinakamahusay na gumaganap.
Programmatic access sa mga pagpapatupad
Higit pa sa UI, inilalantad ng MLflow ang isang client API sa Python, Java, R, at REST na nagbibigay-daan sa iyong mag-query sa run data sa pamamagitan ng programming. Halimbawa, maaari mong gamitin ang:
- mga_pagtakbo_sa_paghahanap para makakuha ng DataFrame (Pandas o Spark) na may mga pagpapatupad ng isang eksperimento, na sinasala ayon sa mga sukatan o label.
- tumakbo upang makuha ang lahat ng impormasyon na nauugnay sa isang partikular na pagtakbo.
- list_run_infos upang ilista ang mga execution identifier at pangunahing metadata.
Gayunpaman, ang istruktura ng mga bagay na ito ay maaaring medyo mahirap, kaya maraming tao ang pumipiling i-convert muna ang mga ito sa mga diksyunaryo o linisin ang mga DataFrame , at mula roon ay bumubuo ng mga custom na dashboard at pagsusuri sa ebolusyon ng mga sukatan sa paglipas ng panahon o sa pag-uugali ng iba't ibang mga gumagamit.
Pagsubaybay gamit ang MLflow sa mga platform tulad ng Azure Databricks
Kung nagtatrabaho ka sa mga pinamamahalaang kapaligiran tulad ng Azure Databricks, karamihan sa imprastraktura ay naayos na: Ang MLflow ay naka-install na sa mga Runtime ML cluster at ang workspace ay may kasamang naka-host na tracking server, kaya hindi mo na kailangang mag-set up nito nang mag-isa.
Sa kontekstong ito, nagbabago ang ilang detalye, ngunit pareho pa rin ang pilosopiya: pamahalaan ang mga eksperimento, pagpapatupad, at modelo gamit ang karaniwang MLflow API, umaasa sa mga karagdagang kagamitan sa platform.
Pagsubaybay at mga eksperimento sa URI sa Databricks
Bilang default, ang tala ng mga notebook ng Databricks ay tumatakbo sa eksperimentong nauugnay sa mismong notebook , nang hindi mo kinakailangang tukuyin ang anumang bagay. Gayunpaman, maaari mo itong baguhin sa pamamagitan ng pag-configure:
- La pagsubaybay sa URIHalimbawa, para tumuro sa isa pang remote na workspace ng Databricks.
- El pangalan ng eksperimento kung saan mo gustong i-record ang mga pagtakbo, gamit ang
mlflow.set_experiment().
Kung hindi ka magtatakda ng aktibong eksperimento, ang mga pagpapatakbo ay mapupunta sa default na eksperimento ng notebook; para sa mas organisadong mga proyekto, karaniwang mas mainam na i-centralize ang mga pagpapatakbo sa mga eksperimento sa workspace na nagpapangkat ng ilang magkakaugnay na notebook.
Awtomatikong pagpaparehistro at mga API sa MLflow 2.xy 3
Ang Databricks ay nagpapanatili ng mga halimbawang notebook na nagtuturo kung paano gamitin ang autolog kasama ang scikit-learn at iba pang mga framework, kapwa para sa MLflow 2.x at para sa MLflow 3, na nagpapakilala ng mga advanced na tampok tulad ng susunod na henerasyon ng LoggedModels.
Mayroon ding mga halimbawa na nakatuon sa paggamit ng manual logging API (Python, REST, R, at Java), para sa mga pagkakataong kailangan mo ng higit na kontrol sa kung ano ang naka-log, pagla-attach ng mga trace, CSV, custom graph, o iba pang artifact na hindi nakukuha ng autolog bilang default.
Pagsusuri ng mga pagpapatupad gamit ang DataFrames
Ginagawang partikular na maginhawa ng Databricks ang pagbuo ng mga dashboard dahil mayroon kang parehong Pandas at Spark na madaling magamit . Dalawang karaniwang paraan upang suriin ang mga pagpapatupad ay:
- Gamitin mlflow.search_runs mula sa Python client upang makakuha ng Pandas DataFrame na may mga pagpapatakbo ng isa o higit pang mga eksperimento.
- Gamitin ang Pinagmulan ng datos ng eksperimento sa MLflow Para mabasa ang mga execution bilang isang Spark DataFrame, mainam kung marami kang runs o gustong gumawa ng mga kumplikadong aggregation.
Gamit ang mga tool na ito, makakabuo ka ng mga dashboard na nagpapakita, halimbawa, ng ebolusyon ng performance ng modelo sa paglipas ng panahon, ang bilang ng mga pagpapatakbo na sinimulan ng bawat user, o ang kabuuang dami ng mga pagpapatupad bawat araw.
Tungkol sa pagkakaiba-iba sa mga resulta ng pagsasanay
Isang mahalagang isyu kapag sinusuri ang mga resulta gamit ang MLflow ay ang pag-unawa na maraming algorithm ang may mga random na bahagi : mga initialization, sampling, partitioning… Kahit na inaayos ang mga seed, ang maliliit na pagkakaiba-iba sa pagkakasunod-sunod ng data o distributed partitioning ay maaaring maging sanhi ng pagkakaiba ng mga sukatan mula sa isang run patungo sa isa pa.
Sa mga daloy ng trabaho ng Spark at mga ipinamahaging datos, maaaring tumaas ang baryasyong ito, kaya inirerekomenda, kung makatuwiran, na gumamit ng mga function tulad ng repartition at sortWithinPartitions upang mas mahusay na makontrol ang pagkakasunud-sunod at distribusyon ng datos bago ang pagsasanay, nang hindi nahuhumaling sa pagkuha ng mga numerong kapareho ng milimetro.
Mga advanced na workflow at mga halimbawa ng paggamit ng MLflow
Higit pa sa basic tracking, nag-aalok ang MLflow ng mga halimbawa at tutorial para sa mas kumplikadong mga workflow , na sumasaklaw sa lahat mula sa multi-step orchestration hanggang sa code supply chain assurance at integration sa mga deep learning framework o LLM.
Ang mga mapagkukunang ito ay nakaayos sa mga tematikong bloke na tutulong sa iyong tumuon sa kung ano ang pinaka-interesante para sa iyo: hyperparameter optimization, reproducibility, seguridad, integrasyon sa mga partikular na framework, o mga custom na extension sa pamamagitan ng mga plugin.
Mga pangunahing daloy ng trabaho at paggamit ng API at REST
Kung ang iyong prayoridad ay masulit ang iyong mga modelo na may iba't ibang configuration, ipapakita sa iyo ng halimbawa ng hyperparameter search kung paano maglunsad ng grid o random na mga paghahanap, pagsasama ng mga tool tulad ng Optuna at pagtatala ng lahat ng resulta upang pagkatapos ay ihambing ang mga ito sa UI.
Kapag mas kumplikado ang iyong pipeline (preprocessing, training, postprocessing, evaluation…), may mga gabay na nagpapaliwanag kung paano i-orkestra ang mga multi-step flow , para maitala ng bawat yugto ang sarili nitong mga artifact at metric, ngunit lahat ay nauugnay sa parehong eksperimento at mga kaugnay na execution.
Kung mas gusto mong makipag-usap nang direkta sa server nang walang mga SDK, mayroon ding mga halimbawa kung paano gamitin ang MLflow REST API gamit ang curl o Python , na nagpapadala ng mga kahilingan upang lumikha ng mga run, mag-log ng mga sukatan, o pamahalaan ang mga modelo nang hindi umaasa sa isang partikular na wika.
Kakayahang kopyahin at seguridad ng supply chain
Ang reproducibility ay isang seryosong isyu sa machine learning. Ang MLflow ay mahusay na isinasama sa mga pamamaraan kung saan inilalagay mo ang lahat ng iyong pagsasanay sa isang Docker container , kabilang ang code, mga dependency, at mga tracking call. May mga tutorial na nagtuturo sa iyo kung paano bumuo ng imahe, i-upload ito sa isang registry, at patakbuhin ito sa isang kontroladong kapaligiran, habang pinapanatili ang isang pare-parehong kapaligiran.
Tungkol sa seguridad, may mga halimbawa ng proteksyon laban sa pakikialam sa pakete ng Python , tulad ng mga signing wheel, pag-verify ng mga checksum, at pagsasama ng mga hakbang na ito sa iyong CI/CD pipeline. Tinitiyak nito na ang code na nakarehistro sa MLflow ay ang code na isasagawa sa ibang pagkakataon at binabawasan ang karaniwang dahilan ng "gumagana ito sa aking makina."
Ipatupad ang training code gamit ang iba't ibang framework
Ang MLflow ay may mga integrasyon sa napakalawak na hanay ng mga library, kabilang ang mga para sa classic at deep learning machine learning, time series, NLP, statistics, at LLM workflows . Ilang mahahalagang halimbawa:
- Mga klasikong modelo: scikit-learn, XGBoost, LightGBM, H2O, RAPIDS at iba pa.
- Deep learning: Keras, TensorFlow, PyTorch, na may suporta para sa pagtatala ng mga training curve, checkpoint, at mga sukatan ng GPU.
- Serye ng oras: Propeta, pmdarima, na may pag-log ng mga pana-panahong bahagi at mga sukatan ng pagtataya.
- Estadistika at R: integrasyon sa mga modelo at aklatan ng Stats tulad ng glmnet sa R, mga koepisyente ng pagtatala, mga buod, at mga diagnostic graph.
- NLP at Transformers: spaCy at Transformers mula sa Hugging Face, na nagbibigay-daan sa iyong i-log ang mga bigat ng modelo, mga halimbawa ng nabuong teksto, at mga marka ng ebalwasyon.
- Kakayahang Ipaliwanag: Pagsasama ng SHAP para sa i-save ang mga halaga ng pagpapatungkol ng tampok at i-visualize ang mga ito sa UI.
- Mga Daloy ng Trabaho ng LLM: Mga gabay gamit ang LangChain at OpenAI sa mga prompt, tugon, kasaysayan ng pag-uusap, at mga sukatan ng kalidad ng instrumento.
Sa lahat ng mga kasong ito, ang pilosopiya ay magkatulad: bawasan ang boilerplate ng pag-log sa pamamagitan ng paggamit ng mga partikular na API ng bawat balangkas, ngunit pinapanatili ang isang pare-parehong modelo ng mga parameter, sukatan, artifact, at mga naka-log na modelo.
Palawakin ang MLflow gamit ang sarili mong mga plugin
Kung ang iyong use case ay wala sa pamantayan, pinapayagan ka rin ng MLflow na bumuo ng mga custom na plugin upang magdagdag ng mga bagong modelo, mga tindahan ng artifact, o kahit na mga karagdagang UI tab. Ipinapaliwanag ng mga tutorial sa plugin kung paano.
- Tukuyin ang lohika ng plugin (halimbawa, isang bagong uri ng modelo o integrasyon sa isang corporate file system).
- I-package ito at i-install sa iyong development at production environment.
- Subukan at i-debug ito nang lokal bago ito i-deploy sa ibang mga user.
Sa ganitong paraan, maaari mong iakma ang MLflow sa mga partikular na pangangailangan ng iyong organisasyon nang hindi kinakailangang i-fork ang orihinal na proyekto, habang nananatiling nakaayon sa mga opisyal na bersyon.
Dahil sa lahat ng ito, ang MLflow ay nagiging isang uri ng "command center" para sa iyong mga proyekto sa machine learning at deep learning: tinutulungan ka nitong kontrolin ang iyong mga eksperimento, nagbibigay-daan sa iyong ihambing ang mga variant sa maayos na paraan, pinapadali ang paggawa ng mga pagsasanay, itinataguyod ang pagsubaybay sa code, at pinapasimple ang pag-deploy ng mga modelo bilang mga serbisyo o REST endpoint, kapwa sa iyong sariling mga server at sa mga pampublikong cloud, na direktang nagreresulta sa mas mabilis na mga cycle ng pag-develop, mas kaunting kaguluhan, at mas madaling mapanatili ang mga modelo ng produksyon.

Masigasig na manunulat tungkol sa mundo ng mga byte at teknolohiya sa pangkalahatan. Gustung-gusto kong ibahagi ang aking kaalaman sa pamamagitan ng pagsusulat, at iyon ang gagawin ko sa blog na ito, ipakita sa iyo ang lahat ng mga pinaka-kagiliw-giliw na bagay tungkol sa mga gadget, software, hardware, teknolohikal na uso, at higit pa. Ang layunin ko ay tulungan kang mag-navigate sa digital na mundo sa simple at nakakaaliw na paraan.
Talatuntunan
- 1 Ano ang MLflow at bakit ito madalas gamitin sa mga MLOp?
- 2 Mga kinakailangan para sa pag-set up ng MLflow server sa produksyon
- 3 Hakbang-hakbang na pag-install ng MLflow sa isang virtual machine
- 4 Pagkonekta ng MLflow sa isang relational database
- 5 I-configure ang imbakan ng artifact gamit ang data lake
- 6 Paglulunsad ng MLflow server gamit ang isang remote backend
- 7 Paano gamitin ang MLflow Tracking para isaayos ang iyong mga eksperimento
- 8 Mga praktikal na halimbawa ng pagsubaybay gamit ang MLflow
- 9 Pagsubaybay gamit ang MLflow sa mga platform tulad ng Azure Databricks
- 10 Mga advanced na workflow at mga halimbawa ng paggamit ng MLflow