- V3.2‑Exp дебютирует с DSA: детальное разреженное внимание к длинному контексту.
- Сравнимая производительность с V3.1‑Terminus и на 50% меньшая стоимость API.
- Доступно в виде приложения, веб-сайта и API; лицензия MIT и открытые ядра.
- Поддержка vLLM с первого дня и простое развертывание с помощью SGLang и Hugging Face.

В то время как генеративный ИИ не демонстрирует признаков замедления, DeepSeek сделал свой шаг, выпустив модель, напрямую ориентированную на повышение эффективности и учет долгосрочного контекста. DeepSeek-V3.2-Exp — это экспериментальная модель, призванная подтвердить существенное изменение в производстве: новый распределенный механизм внимания, который обещает ускорить обучение и вывод без ущерба для качества выходных данных.
Новая модель не начинается с нуля; она основана на V3.1-Terminus, но вводит ключевой механизм под названием DeepSeek Sparse Attention (DSA) . DeepSeek утверждает, что с помощью DSA можно сократить вычислительные затраты и, как следствие, снизить стоимость API более чем на 50% с немедленным вступлением в силу, сохраняя при этом производительность, сопоставимую с предшественником, в различных задачах.
Что такое DeepSeek-V3.2-Exp и почему это важно
DeepSeek определяет V3.2-Exp как промежуточный шаг на пути к своей следующей архитектуре, шаг, предназначенный для тестирования и демонстрации конкретных оптимизаций эффективности в сценариях с длинным контекстом . По словам компании, цель состоит в ускорении как обучения, так и вывода результатов при обработке обширных текстовых последовательностей, где традиционные трансформеры обычно увеличивают затраты.
Главное, что этот запуск носит экспериментальный характер , но не является единичным случаем: он доступен в приложении DeepSeek, на веб-сайте и в API с первого дня, открывая разработчикам, командам обработки данных и исследователям возможность протестировать его в реальных условиях с большим объемом контекстной информации.
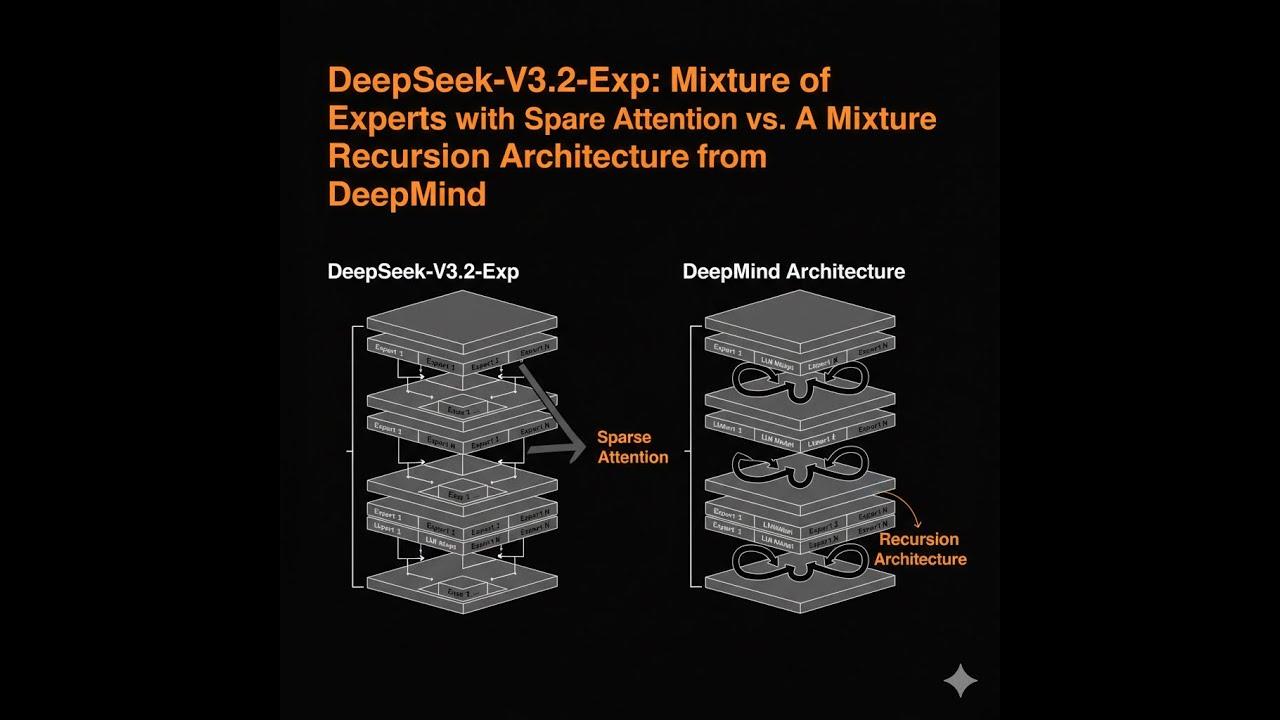
Технически, версия V3.2-Exp наследует основы V3.1-Terminus для поддержания качества и обеспечения справедливого сравнения. DeepSeek указывает, что намеренно согласовала конфигурации обучения с Terminus, чтобы измерить истинное влияние алгоритмов поиска и анализа, а внутренние тесты показывают сопоставимые результаты в поиске, программировании и математике.
Помимо цифр, важен рыночный контекст: объявление о X подчеркивает его доступность и снижение цены API более чем на 50%. Послание ясно : повышение эффективности приводит к снижению затрат, оказывая давление на конкурентов в Китае и за рубежом, таких как Qwen от Alibaba или американские аналоги.
Что представляет DeepSeek Sparse Attention (DSA)
DSA — это мелкозернистый, разреженный механизм внимания , ориентированный на длинные контекстные окна. Вместо того чтобы уделять внимание всем токенам одинаково, он отдает приоритет действительно релевантным фрагментам и сокращает ненужную работу, сохраняя при этом практически идентичное качество выходных данных.
Для достижения этой цели DeepSeek использует модуль под названием Lightning Indexer , функция которого заключается в определении приоритетности определенных областей контекстного окна. Этот шаг предшествует поиску и действует как интеллектуальный фильтр, отделяющий важное от лишнего.
После первоначального отбора модель применяет процесс детального выбора токенов . На практике это означает, что не все токены конкурируют за внимание: только те, которые определены как наиболее информативные, попадают в окно распределенного внимания, что снижает потребление памяти и вычислительных ресурсов.
Положительным побочным эффектом является то, что система может учитывать большой объем контекста и поддерживать несколько линий рассуждений одновременно, не перегружаясь. Это особенно полезно в длительных рабочих процессах, при сложном анализе документов или продолжительных многопоточных обсуждениях.
Как это работает: индексатор Lightning и выбор токенов
Концептуальный конвейер, описанный DeepSeek, можно упростить до нескольких взаимосвязанных этапов, каждый из которых играет определенную роль для максимизации эффективности в долгосрочных условиях. Оптимизация основана на принятии более обоснованных решений, а не на обработке большего объема данных.
- Быстрая приоритизация: Индексатор молнии Он сканирует окно и выделяет фрагменты-кандидаты с высокой семантической или структурной релевантностью.
- Тонкая утонченность: детальный выбор токенов, который определяет, какие токены фактически попадают в фокус рассеянного внимания.
- Эффективный уход: DSA применяет внимание только к выбранному подмножеству, экономя вычисления и память по сравнению с традиционным плотным вниманием.
- Сопоставимый результат: качество модели поддерживается на практике на основе внутренних тестов с V3.1-Terminus.
DeepSeek подчеркивает, что эта стратегия не является разовой уловкой: цель состоит в том, чтобы подтвердить и закрепить улучшения в эффективности для будущей архитектуры. Другими словами, V3.2-Exp — это реальная площадка для тестирования, но уже пригодная для использования в производственной среде.
Кроме того, компания отмечает, что такой подход позволяет модели самостоятельно проверять определенные параметры во время обучения в сценариях с длительным контекстом, динамически регулируя вычислительные затраты в зависимости от того, что фактически предоставляет информацию.
Производительность, тесты и стоимость: на 50% меньше на API
Одним из наиболее поразительных результатов является то, что производительность V3.2-Exp сопоставима с V3.1-Terminus в ключевых областях: в качестве поискового агента, в задачах программирования и в математических задачах. Сохранение аналогичных результатов при меньшей вычислительной мощности позволяет снизить цену.
Компания DeepSeek объявила о немедленном снижении цен на API более чем на 50% благодаря повышению эффективности, достигнутому с помощью алгоритмов DSA. Это решение не только делает технологию более доступной, но и повышает ее конкурентоспособность для конкурентов, которым приходится обосновывать более высокие затраты на использование.
С точки зрения практического опыта, улучшение особенно заметно в сценариях с длинным контекстом : обширный анализ данных, обработка юридических или технических документов, операции бэк-офиса с длительной историей и любой конвейер обработки данных, основанный на очень длинных текстовых последовательностях.
Гипотеза DeepSeek ясна: если модель сможет избирательно обращать внимание на то, что важно, организация сможет выполнять больший объем работы с той же инфраструктурой или ту же рабочую нагрузку с меньшими затратами, не теряя при этом надежности результата.
Доступность, открытый исходный код и лицензирование
Версия V3.2-Exp доступна в приложении DeepSeek, веб-версии и API . Модель является открытым исходным кодом, и любой желающий может оценить её работу. Репозиторий и веса модели распространяются под лицензией MIT , что поощряет исследования и коммерческое использование.
Такая открытость контрастирует с более закрытыми подходами и демократизирует доступ к передовым возможностям. Она также укрепляет роль Китая в гонке за искусственный интеллект , упрощая университетам, стартапам, а также местным и международным компаниям использование и модификацию существующего технологического стека.
Компания подчеркивает экспериментальный характер релиза: он служит предварительным показом того, что может появиться в архитектуре следующего поколения. Тем не менее, стабильный релиз на трех основных каналах свидетельствует о достаточном уровне зрелости для реального использования.
Справочные ссылки: репозиторий и техническая документация на GitHub, модель на Hugging Face , а также контактная информация службы поддержки по адресу [email protected] Весь пакет направлен на содействие его внедрению в сообществе.
Краткое руководство по локальному запуску
DeepSeek предлагает обновленную демонстрацию процесса инференции, разработанную для ускорения запуска и помощи сообществу в понимании архитектуры. Рабочий процесс с использованием функции Hugging Face и преобразования весов прост и поддерживает параллельную обработку моделей в зависимости от используемых графических процессоров.
cd inference
export EXPERTS=256
python convert.py --hf-ckpt-path ${HF_CKPT_PATH} --save-path ${SAVE_PATH} --n-experts ${EXPERTS} --model-parallel ${MP}

export CONFIG=config_671B_v3.2.json
torchrun --nproc-per-node ${MP} generate.py --ckpt-path ${SAVE_PATH} --config ${CONFIG} --interactive
Для тех, кто предпочитает использовать модель на основе SGLang, доступны образы Docker для различных архитектур. Теги охватывают графические процессоры NVIDIA , ROCm и NPU , включая конкретные варианты.
# H200
docker pull lmsysorg/sglang:dsv32
# MI350 (ROCm)
docker pull lmsysorg/sglang:dsv32-rocm
# NPUs
docker pull lmsysorg/sglang:dsv32-a2
docker pull lmsysorg/sglang:dsv32-a3

# Lanzar servidor
python -m sglang.launch_server --model deepseek-ai/DeepSeek-V3.2-Exp --tp 8 --dp 8 --page-size 64
Если вы используете vLLM, проект объявляет о поддержке версии V3.2-Exp с первого дня . Актуальную информацию о конфигурации, постраничной навигации ключ-значение и параметрах производительности можно найти в официальных рецептах.
Во всех случаях рекомендуется настраивать MP в соответствии с количеством доступных графических процессоров и отслеживать фактическое использование памяти. Это позволяет достичь оптимального баланса между задержкой, пропускной способностью и стоимостью запроса.
Открытые ядра и поддержка экосистемы
Компания DeepSeek выпустила несколько компонентов, которые упрощают исследовательскую и производственную деятельность. Тем, кто уделяет первостепенное внимание читаемости и дизайну в исследовательских целях, в качестве отправной точки рекомендуется TileLang .
Для обеспечения максимальной производительности CUDA в DeepGEMM доступны ядра индексатора с логистической регрессией (включая страничные варианты). В то же время в FlashMLA опубликованы ядра с разреженным вниманием , предназначенные для повышения эффективности на современных графических процессорах.
Этот модульный подход позволяет комбинировать компоненты по мере необходимости: для повышения читаемости кода при прототипировании и обучении, или для высокопроизводительных ядер, необходимых для выполнения сложных вычислений в реальных условиях. Это именно то, что нужно для перехода от тестирования к производству без перестройки всего конвейера.
Кроме того, публикация этих ядер с акцентом на долгосрочный контекст дополняет инициативу DSA, замыкая круг между прикладными исследованиями , сравнительным анализом и внедрением в реальных условиях.
Стратегическое воздействие и что дальше
Тот факт, что экспериментальная модель запускается в виде приложения, веб-приложения и API с немедленным снижением цены, является явным заявлением о намерениях. DeepSeek не просто изучает новое направление исследований; она превращает его в продукт и передает сэкономленные средства конечному пользователю.
Этот шаг усиливает давление на конкурентов в китайской экосистеме, таких как Qwen от Alibaba и ее американские аналоги. Если показатели останутся на уровне более дорогих альтернатив, цена может переломить ситуацию в секторах, чувствительных к издержкам.
Еще одним следствием является эффект открытого исходного кода : разрешительные лицензии, общедоступные ядра и широкая поддержка ускоряют внедрение и облегчают аудит, обучение и внесение вклада. Это резко контрастирует с закрытыми моделями и открывает двери для малых и средних предприятий и университетских лабораторий.
С точки зрения повествования, интересно, как DeepSeek представляет V3.2-Exp как взгляд в будущее : он подтверждает тонко настроенные механизмы внимания и сравнивает их влияние, сохраняя при этом все остальные факторы неизменными. Такая сравнительная строгость придает результатам достоверность.
Также важна способность обрабатывать несколько параллельных линий рассуждений . Умение поддерживать несколько цепочек рассуждений без существенного увеличения затрат открывает возможности в сложных агентах, многоэтапных рассуждениях и системах, сочетающих поиск, синтез и проверку.
Ссылки, цитирование и контакты
Для тех, кто хочет углубиться в тему, DeepSeek предоставляет ссылки на модель на Hugging Face и технический отчет на GitHub. Также доступен блок цитирования в формате BibTeX и адрес электронной почты для связи со службой поддержки и ответов на вопросы.
@misc{deepseekai2024deepseekv32,
  title={DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention},
  author={DeepSeek-AI},
  year={2025}
}
В кратком изложении объявления на канале X компания сообщила: представлен DeepSeek-V3.2-Exp , доступный через приложение, веб-сайт и API, при этом цена API снижена более чем на 50%. Основное внимание по-прежнему уделяется долгосрочному контексту и сквозной эффективности.
Тем временем технологические СМИ осветили запуск, позиционируя его как важный шаг после успеха V3 и R1 и предполагая, что, если он оправдает ожидания, то поднимет планку качества и цены по сравнению с основными игроками в этом секторе.
Чтобы замкнуть круг, стоит вспомнить недавний период: с момента запуска ChatGPT в 2022 году и до сегодняшнего дня генеративный ИИ развивался беспрецедентными темпами. Версия 3.2-Exp вписывается в эту тенденцию: больше контекста, меньшая стоимость и архитектура, которая учится на собственных экспериментах.
V3.2-Exp позиционируется как жизнеспособный вариант для проектов, требующих обширных контекстов, скорости и контроля затрат . Его мелкозернистый, распределенный подход к вниманию, поддержка экосистемы (vLLM, SGLang, открытые ядра) и лицензия MIT делают его особенно привлекательным как для прикладных исследований, так и для корпоративных развертываний, где каждая миллисекунда и каждый евро имеют значение.

Страстный писатель о мире байтов и технологий в целом. Мне нравится делиться своими знаниями в письменной форме, и именно этим я и займусь в этом блоге: покажу вам все самое интересное о гаджетах, программном обеспечении, оборудовании, технологических тенденциях и многом другом. Моя цель — помочь вам ориентироваться в цифровом мире простым и интересным способом.