- A segurança sem clock está relacionada a projetos de CPU assíncronos, onde a dependência de um clock global é reduzida ou eliminada.
- Os processadores modernos combinam caches, MMUs (Unidades de Medição de Memória), paralelismo e múltiplas threads, o que complica tanto o desempenho quanto a segurança.
- Projetos sem relógio podem mitigar ataques de temporização, mas exigem novas formas de monitoramento e auditoria. Hardwares.
- A virtualização, as vCPUs e os aceleradores especializados expandem a superfície de ataque, tornando essencial a integração da segurança desde o nível do silício.
O termo "segurança sem clock" soa como um conceito futurista , mas na verdade está intimamente ligado à forma como os processadores e sistemas atuais são projetados e protegidos. Para compreendê-lo completamente, precisamos analisar como uma CPU funciona internamente, como a execução de instruções é organizada e o papel do famoso sinal de clock que define o ritmo de todo o sistema.
Nas últimas décadas, os processadores têm se empenhado em uma corrida para aumentar as velocidades de clock, integrar mais transistores e multiplicar seu paralelismo . Simultaneamente, surgiram projetos que tentam se libertar da dependência do clock global, seja em todo o chip ou em partes específicas. Esse território — o dos projetos assíncronos ou sem clock — abre oportunidades muito interessantes em termos de consumo de energia e dissipação de calor… e também desafios de segurança específicos que são frequentemente agrupados sob o conceito de segurança sem clock.
A CPU como centro do sistema e sua relação com o relógio.
Quando falamos de segurança relacionada ao relógio, a primeira coisa a lembrar é exatamente o que é uma CPU. Essencialmente, a unidade central de processamento é o cérebro do computador : o componente que interpreta e executa instruções de programa, coordena a memória, a entrada/saída e coprocessadores especializados, como as GPUs.
Dentro de uma CPU moderna, encontramos diversos blocos distintos. De um lado, temos a unidade lógica aritmética (ULA) , responsável por operações matemáticas e lógicas com números inteiros. De outro, estão os registradores, que são pequenas memórias ultrarrápidas onde os dados com os quais o processador está trabalhando são armazenados. E, acima de tudo, há uma unidade de controle que decide, ciclo a ciclo, o que fazer, o que ler da memória e o que escrever.
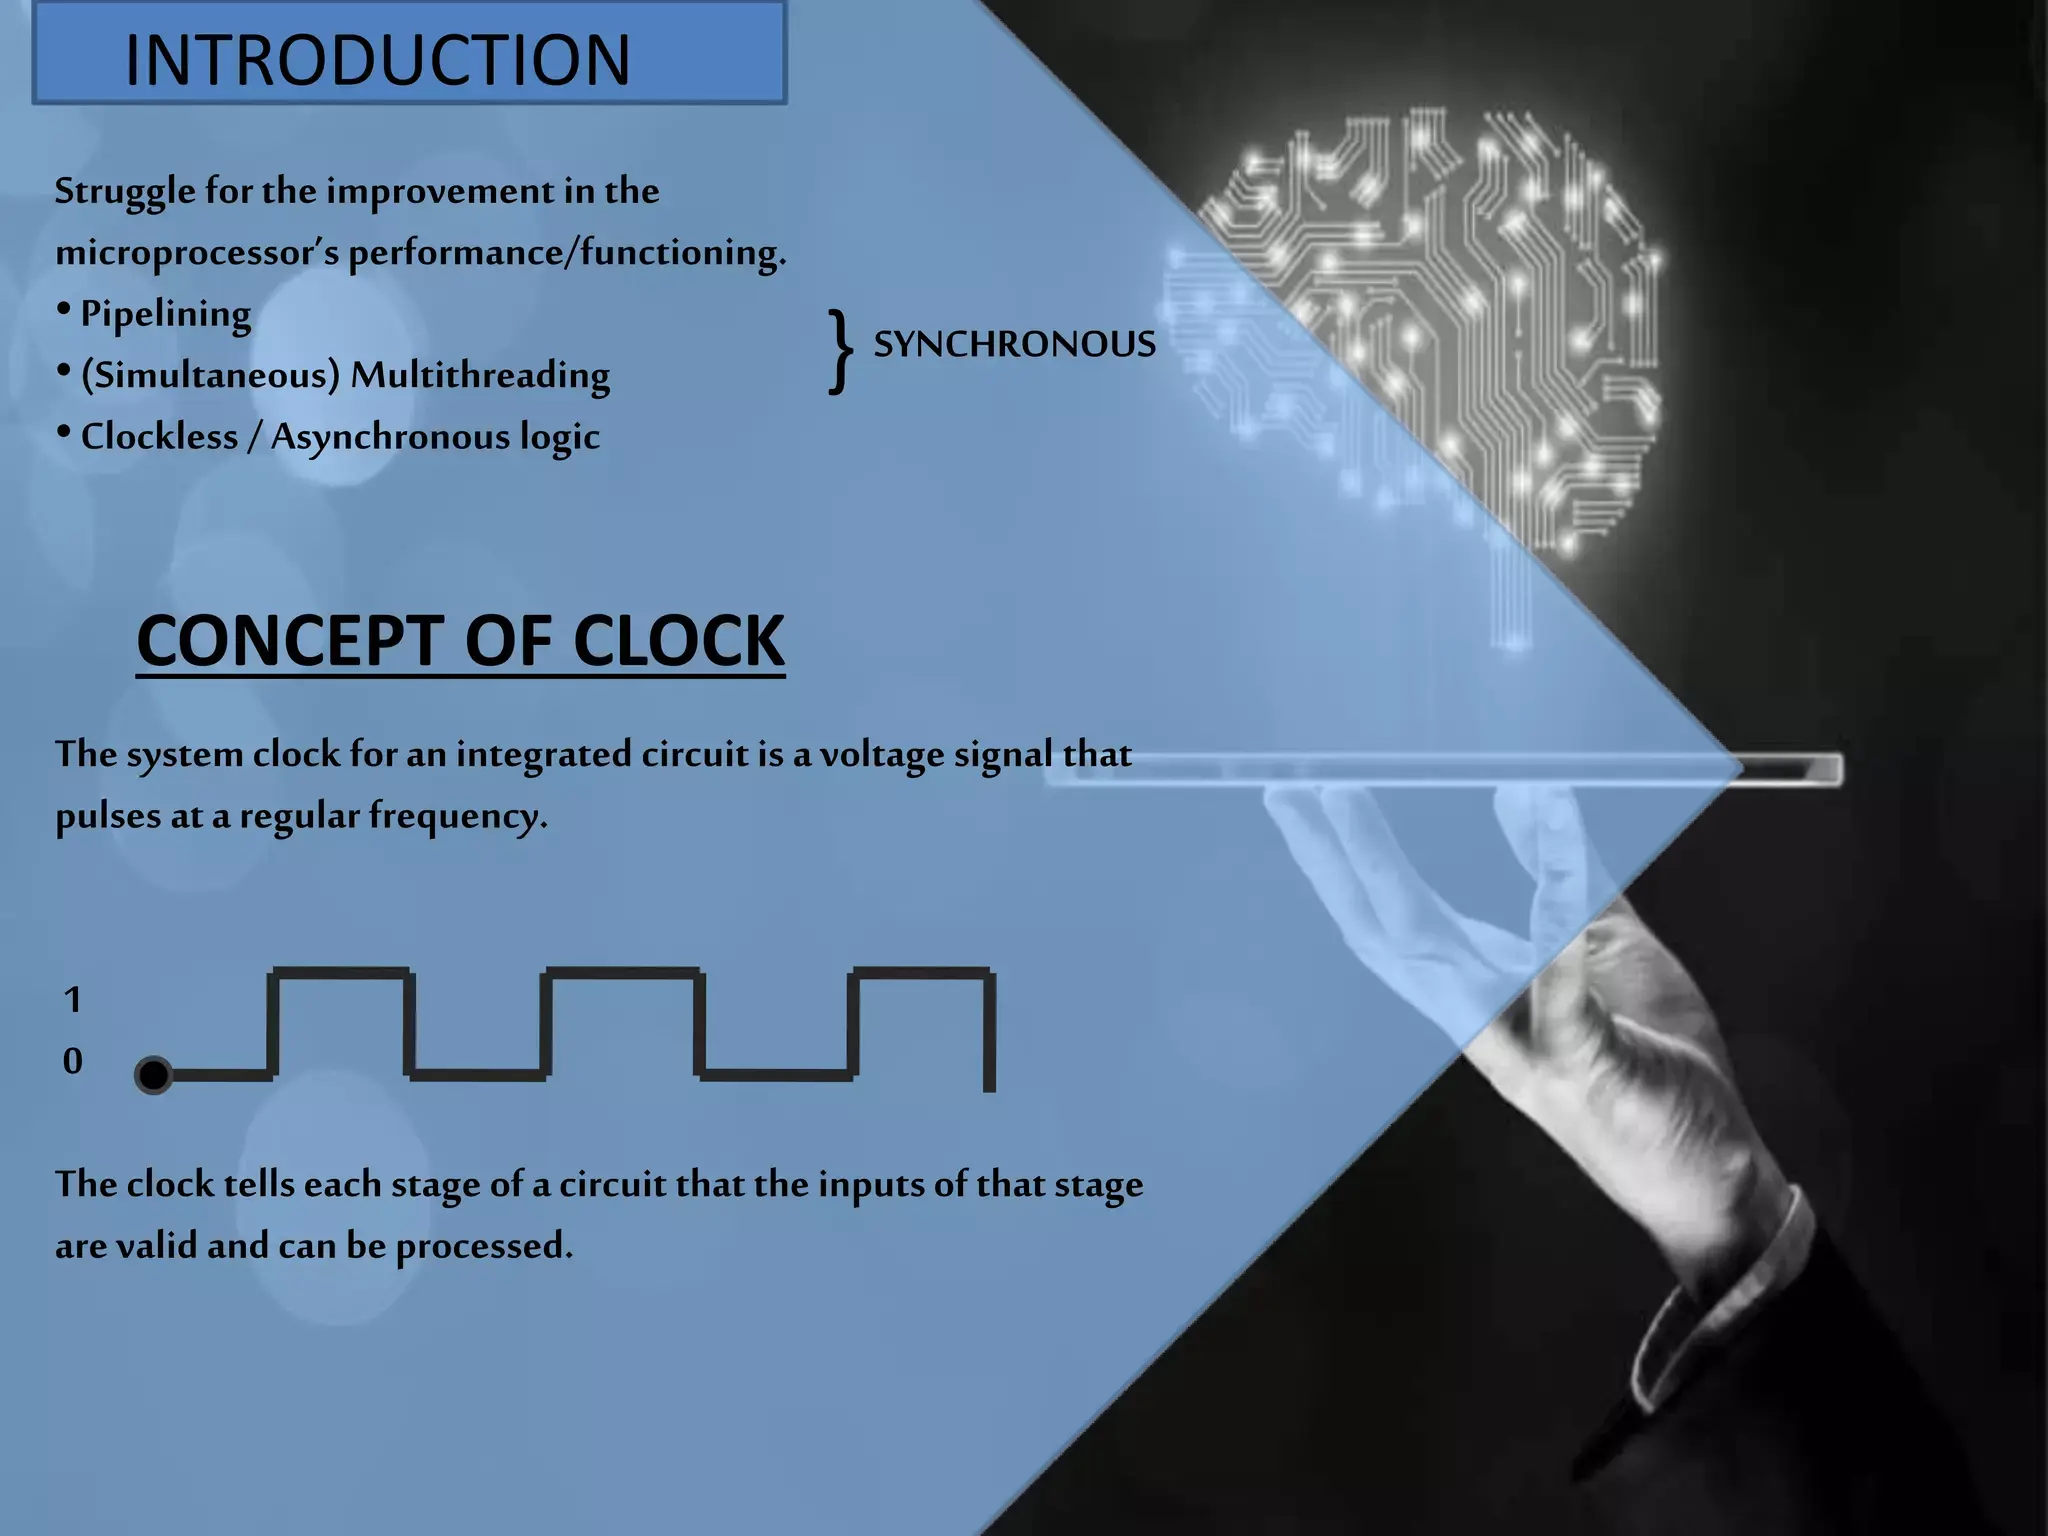
A maioria dos processadores modernos são de projeto síncrono. Isso significa que todos os seus blocos internos são coordenados por um sinal de clock periódico , uma espécie de metrônomo eletrônico que define o ritmo de execução. Cada transição de clock avança uma etapa do ciclo de instrução: a instrução é buscada, decodificada, executada, os resultados são armazenados e o ciclo recomeça.
Em um processador tradicional, o clock é gerado por um oscilador externo que envia milhões ou bilhões de pulsos por segundo. A frequência desses pulsos, medida em hertz, megahertz ou gigahertz, indica quantos "ticks" a CPU tem disponíveis a cada segundo para processar dados e realizar operações. Uma frequência de clock mais alta significa maior poder de processamento potencial por segundo , desde que o restante da arquitetura suporte isso.
Assim, o desempenho depende não apenas da velocidade do clock, mas também de quantas instruções por ciclo (IPC) o processador é capaz de executar. O produto da velocidade do clock pelo IPC nos dá uma ideia dos milhões de instruções por segundo que ele pode executar, embora os valores teóricos sejam geralmente muito mais otimistas do que o que se observa na prática com programas reais.
Da fiação fixa aos microprocessadores integrados
Para contextualizar os projetos sem clock, é útil revisar a evolução da CPU. Os primeiros computadores eletrônicos, como o ENIAC, eram máquinas com programas fixos e circuitos integrados : para alterar tarefas, o sistema precisava ser fisicamente reconfigurado. A ideia revolucionária foi o computador com programa armazenado, no qual as instruções residem na memória; o processador simplesmente as lê e as executa.
Essa arquitetura de programa armazenado, associada a John von Neumann, acabou se tornando o padrão. Nela, instruções e dados compartilham o mesmo espaço de memória , diferentemente da arquitetura Harvard, que separa fisicamente os dois tipos de informação. Hoje, quase todas as CPUs de uso geral seguem a arquitetura von Neumann, embora muitos processadores Harvard puros ou híbridos ainda sejam encontrados em sistemas embarcados.
Os primeiros processadores eram construídos usando relés ou válvulas eletrônicas. Eram volumosos, lentos e tinham confiabilidade muito limitada . O salto para os transistores de estado sólido nas décadas de 50 e 60 aumentou radicalmente a velocidade, ao mesmo tempo que reduziu o consumo de energia e o tamanho . A partir daí, o foco mudou de circuitos discretos para circuitos integrados (CIs), com um número cada vez maior de transistores sendo integrados em um único chip.
Com o advento do circuito integrado, primeiro em pequena escala (SSI), depois em média escala (MSI), em grande escala (LSI) e, finalmente, em escala muito grande (VLSI), a CPU foi compactada até caber inteiramente em um ou poucos chips . Essa integração culminou no microprocessador, no qual toda a unidade de processamento é fabricada em um único chip de silício.
O Intel 4004 , lançado em 1971, foi um dos primeiros microprocessadores comerciais. Projetos mais poderosos, como o Intel 8080, logo surgiram e se tornaram a base dos computadores pessoais. A partir desse momento, o termo CPU passou a ser quase sempre usado para se referir a esses microprocessadores.
Componentes internos essenciais de uma CPU moderna
Os processadores modernos dedicam uma grande parte da sua superfície de silício a componentes auxiliares projetados para maximizar a eficiência de cada ciclo de clock . Por exemplo, quase todos os processadores incorporam vários níveis de cache: memórias pequenas, mas muito rápidas, localizadas perto dos núcleos, que armazenam cópias de dados frequentemente usados para que não precisem acessar a RAM constantemente.
Além dos caches L1, L2 e, frequentemente, L3, uma CPU complexa inclui uma unidade de gerenciamento de memória (MMU) que traduz endereços virtuais (aqueles gerenciados pelo sistema operacional) em endereços físicos na RAM, gerencia a memória virtual e fornece isolamento entre os processos.
No plano computacional, temos diversas unidades de execução especializadas: a ULA para números inteiros, a unidade de ponto flutuante (FPU) para operações decimais, unidades de geração de endereços (AGU) para calcular rapidamente posições de memória e, em muitas arquiteturas, unidades vetoriais ou SIMD para operar em vários pontos de dados em paralelo.
Existe também uma unidade de controle, que pode ser implementada por meio de circuitos fixos ou baseada em microcódigo; ou seja, um programa interno que traduz cada instrução de alto nível em uma sequência de sinais de controle internos. Em muitos processadores, esse microcódigo pode ser atualizado, permitindo a correção de erros de projeto ou ajustes subsequentes no comportamento do processador.
Finalmente, há uma série de registradores internos: registradores de uso geral, acumuladores, contadores de programa, registradores de status com flags que indicam coisas como se o resultado de uma operação é zero, negativo ou se ocorreu um estouro de capacidade, etc. Tudo isso é coordenado seguindo o ciclo clássico de busca, decodificação e execução de instruções.
Como executar um programa passo a passo
O funcionamento básico de qualquer CPU se resume a buscar instruções na memória e processá-las uma após a outra. Isso acontece em três fases principais. Primeiro, a fase de busca , na qual a instrução cujo endereço é fornecido pelo contador de programa é lida da memória.
Em seguida, vem a fase de decodificação. A instrução recém-capturada passa por um decodificador binário que examina seu código de operação (opcode) e traduz esse padrão de bits em sinais específicos que habilitam ou desabilitam partes do processador. Isso determina se é uma adição, um salto, um carregamento da memória, etc., e quais registradores ou endereços estão envolvidos.
Finalmente, a operação é executada. A ULA (Unidade Lógica e Aritmética) ou a unidade correspondente realiza o cálculo ou a movimentação de dados, e o resultado geralmente é armazenado em um registrador ou na memória. Se o fluxo do programa precisar ser alterado, por exemplo, com um salto condicional, o contador de programa é atualizado com um novo endereço. Esse conjunto de instruções, dados e saltos é o que, em última análise, forma os laços de repetição, as funções, as condicionais e toda a lógica dos nossos programas.
Em processadores simples, tudo acontece de forma linear e sequencial. Mas as CPUs modernas tentam sobrepor muitas dessas etapas usando técnicas de paralelismo . O objetivo é que cada ciclo de clock execute o máximo de trabalho possível, evitando que o hardware fique ocioso.
Paralelismo, canalização e execução fora de ordem.
Para evitar o desperdício de tempo de processamento, os projetistas introduziram o pipeline de instruções . O caminho de dados é dividido em vários estágios, semelhante a uma linha de montagem. Enquanto uma instrução está sendo decodificada, a próxima já está sendo buscada na memória e outra pode estar sendo executada na ULA (Unidade Lógica e Aritmética).
O problema é que, às vezes, uma instrução precisa do resultado de outra que ainda não foi concluída. Isso cria dependências de dados e força a introdução de "bolhas" ou esperas no pipeline. Para minimizar esses atrasos, foram inventadas técnicas como encaminhamento de operandos, previsão de desvios e, posteriormente, execução fora de ordem , nas quais o processador reordena internamente as instruções, desde que o resultado final do programa seja respeitado.
O próximo passo foi o projeto superescalar: equipar o processador com múltiplas unidades de execução do mesmo tipo para que ele pudesse executar múltiplas instruções por ciclo de clock , desde que não houvesse conflitos entre elas. Um despachante interno analisa o fluxo de instruções, detecta quais instruções podem ser executadas em paralelo e as distribui entre as diferentes unidades.
Todos esses truques se enquadram no conceito de paralelismo em nível de instrução (ILP) . As limitações práticas dessas técnicas e a crescente dificuldade de aumentar ainda mais as velocidades de clock sem aumentar significativamente o consumo de energia e o calor levaram os fabricantes, em determinado momento, a também começar a se concentrar no paralelismo em nível de tarefa : múltiplas threads e múltiplos núcleos por chip (e mecanismos como o estacionamento de núcleos ).
Foi assim que nasceram os processadores multi-core e as arquiteturas de multithreading por hardware , onde cada núcleo pode manter o estado de várias threads de execução e alternar rapidamente entre elas para melhor utilizar os recursos internos enquanto algumas threads aguardam dados da memória.
O papel da frequência do relógio e seus limites físicos
Voltando ao relógio, é importante lembrar que o sinal que sincroniza o processador é, em última análise, um sinal elétrico que se propaga pelo chip . À medida que as frequências aumentam e o número de transistores cresce, manter esse sinal perfeitamente alinhado em todos os pontos torna-se muito difícil. Isso leva a problemas com a distribuição do relógio, defasagens e integridade do sinal.
Por outro lado, cada transição de clock faz com que inúmeros transistores mudem de estado, mesmo que uma determinada área do processador não esteja realizando nenhuma tarefa útil naquele momento. Isso se traduz em consumo de energia e dissipação de calor simplesmente por manter o clock ativo. Para atenuar esse problema, foram introduzidas técnicas como o clock gating, que desliga seletivamente o sinal de clock em blocos não utilizados, reduzindo o consumo de energia.
No entanto, além de um certo limite, aumentar a frequência torna-se inviável: os problemas com consumo de energia, temperatura e distribuição do clock disparam. Esse gargalo é um dos motivos pelos quais a ideia de eliminar, total ou parcialmente, um clock global tem sido explorada: é aí que entram em cena os projetos assíncronos ou "sem clock".
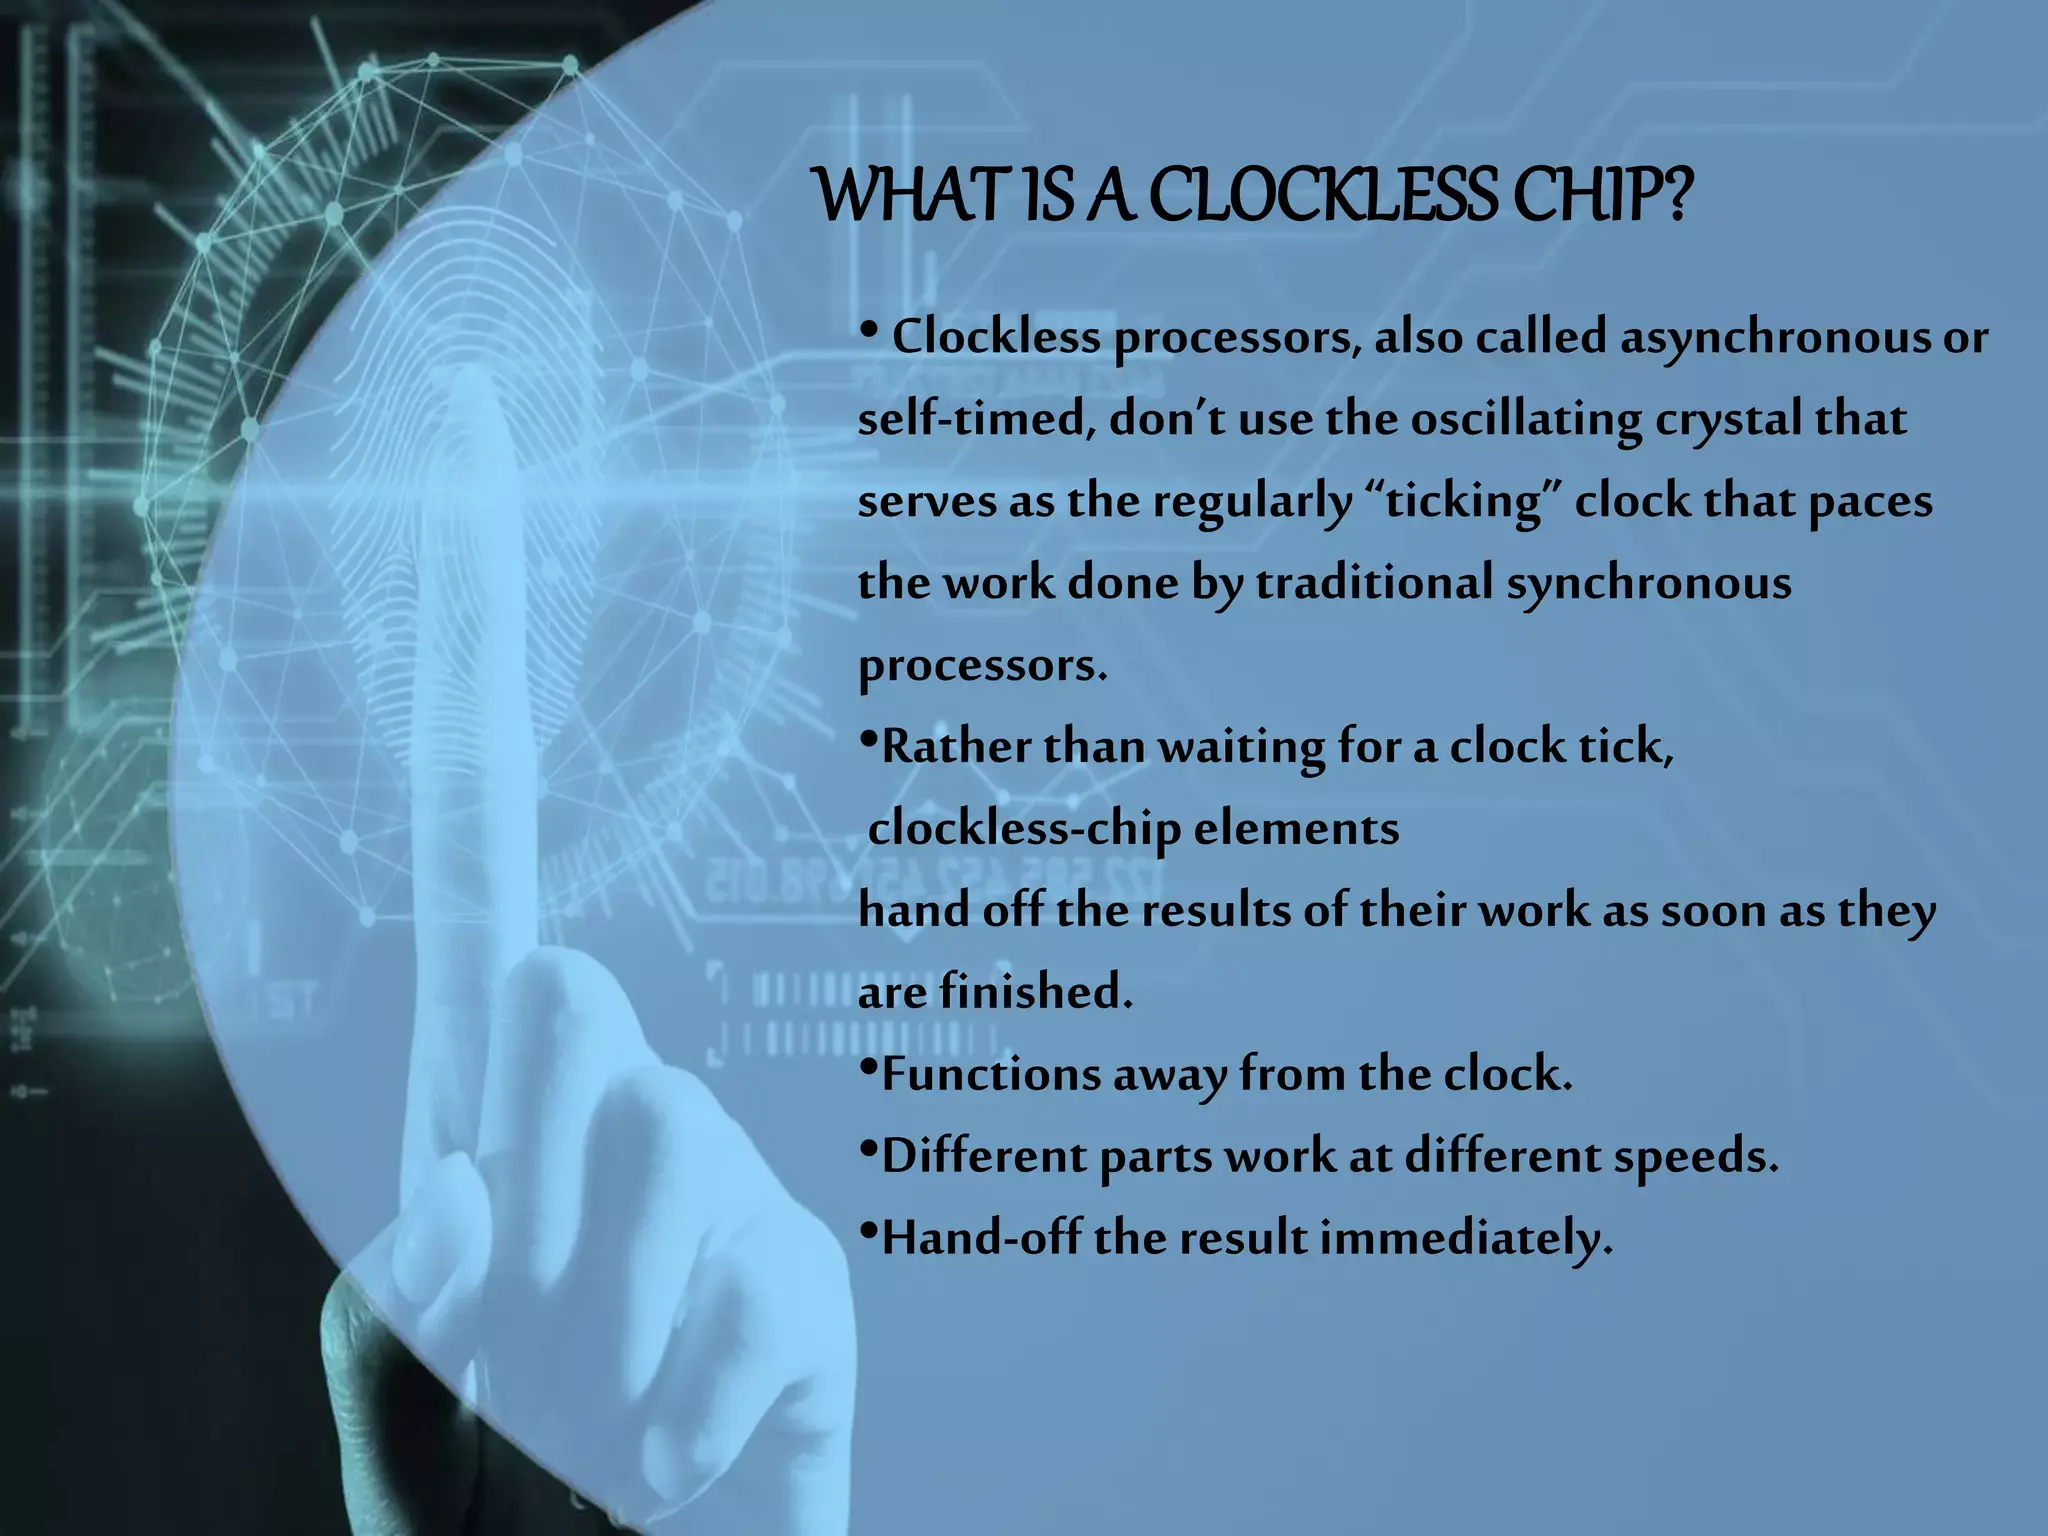
Em um projeto assíncrono, em vez de ter um único relógio que define o tempo para todo o chip, os próprios sinais de dados e controle sincronizam as operações . Os blocos se comunicam usando protocolos de solicitação e confirmação (handshake): quando os dados estão prontos, o produtor notifica o consumidor, e o consumidor reage sem esperar por uma borda de clock fixa.
Processadores totalmente assíncronos compatíveis com conjuntos de instruções conhecidos já foram construídos , como a família AMULET baseada em ARM ou projetos derivados de MIPS. Também existem projetos híbridos, nos quais apenas certas unidades (por exemplo, uma ULA específica) operam sem um clock global, enquanto o restante do processador permanece síncrono.
O que entendemos por segurança sem relógio de ponto?
Quando falamos de segurança sem relógio, estamos combinando duas ideias: por um lado, o design assíncrono como técnica para reduzir o consumo e o calor ; por outro lado, a implicação de dispensar o relógio ao analisar, monitorar e proteger o comportamento do sistema contra ataques ou falhas.
Em sistemas síncronos, muitas ferramentas de segurança e monitoramento dependem da existência de um ritmo temporal estável e previsível . É relativamente fácil contar ciclos, medir quanto tempo uma determinada operação leva ou tentar detectar comportamentos anômalos medindo variações em tempos que deveriam ser constantes.
Em um sistema assíncrono ou parcialmente sem relógio, essas referências de tempo rígidas tornam-se diluídas. O tempo de execução de uma operação pode depender da disponibilidade real de dados, da congestão em certas rotas internas ou de pequenas variações físicas. Da perspectiva de um atacante, isso pode dificultar a execução de ataques de canal lateral baseados em tempo, pois o relógio global que serve como ponto de referência comum desaparece.
No entanto, essa mesma natureza dinâmica também complica as coisas para quem deseja observar e auditar o sistema internamente. Muitas sondas e contadores de hardware são projetados para operar com base em ciclos de clock; sem um clock global claro, medir o desempenho e detectar atividades suspeitas requer outras métricas e mecanismos.
Além disso, o design assíncrono, ao ser liberado do relógio, permite que os caminhos de dados sejam ativados em momentos ligeiramente diferentes em cada execução, potencialmente aleatorizando vazamentos de tempo , mas também abrindo outras possibilidades, por exemplo, na forma de padrões de consumo de energia distintos e mais complexos que poderiam ser explorados por ataques de análise de energia.
Representação de dados, tamanho da palavra e segurança
Outro fator importante relacionado à arquitetura da CPU é como ela representa e manipula os dados. Quase todos os processadores modernos usam representação binária , com valores de tensão correspondentes a 0 e 1. O tamanho da palavra (8, 16, 32, 64 bits…) determina o intervalo de números inteiros que podem ser manipulados diretamente e a quantidade de memória endereçável.
Do ponto de vista da segurança, o tamanho da palavra afeta o espaço de endereçamento e a probabilidade de colisões, estouros de memória e erros de ponteiro . Um sistema de 32 bits com 2^32 endereços possíveis tem limitações muito claras em comparação com um sistema de 64 bits. Além disso, muitos mecanismos de proteção modernos, como certas extensões de memória protegidas, dependem de um grande espaço de endereçamento.
O uso de MMUs e tradução de endereços também introduz uma camada extra entre o programa e a memória física, o que é crucial para isolar processos , implementar memória virtual e proteger o kernel. Em contextos assíncronos, a coordenação entre essas traduções e os sinais entre blocos sem clock deve ser muito bem projetada para evitar vulnerabilidades de segurança ou condições de corrida.
Por sua vez, as extensões vetoriais (SIMDs) e as unidades de ponto flutuante permitem trabalhar com grandes volumes de dados em paralelo. Isso é uma faca de dois gumes: por um lado, acelera os algoritmos criptográficos e as tarefas de análise ; por outro, se explorado maliciosamente, fornece imenso poder computacional para quebrar cifras fracas ou lançar ataques de força bruta.
Em um cenário sem relógio ou parcialmente assíncrono, a forma como essas unidades de computação paralela são programadas e protegidas deve levar em consideração que os padrões de execução e consumo não seguem mais um ritmo fixo definido pelo relógio , mas respondem à dinâmica real dos dados, o que também influencia o projeto de contramedidas contra canais laterais.
Paralelismo massivo, multithreading e vetores: impacto na segurança sem clock.
Os processadores modernos visam aumentar o desempenho não apenas elevando a frequência do clock, mas também executando mais tarefas em paralelo. Isso envolve múltiplos núcleos, multithreading por hardware e unidades vetoriais capazes de processar múltiplos itens de dados por instrução . Soma-se a isso o surgimento de aceleradores dedicados, como GPUs, DSPs e TPUs.
Do ponto de vista da segurança, cada novo bloco de execução e cada novo nível de paralelismo representam uma superfície adicional a ser protegida. É necessário coordenar a consistência do cache, o gerenciamento de memória compartilhada , os mecanismos de exclusão mútua e prevenir condições de corrida e vazamentos de informações entre threads ou processos concorrentes.
Em ambientes híbridos ou sem clock, essa coordenação depende mais de protocolos de comunicação entre blocos do que de ciclos de clock globais. Por exemplo, um kernel pode usar sinais de solicitação e confirmação para acessar a memória ou um recurso compartilhado, e o atraso efetivo dependerá do tráfego real naquele momento, e não de um número fixo de ciclos.
Visto de fora, esse comportamento dificulta certos ataques que dependem de medições de tempo muito precisas, baseadas no número de ciclos de clock. No entanto, os projetistas de segurança precisam ir além da contagem de ciclos e usar contadores de eventos, medição de tráfego, consumo de energia e outros sinais para detectar comportamentos suspeitos.
É por isso que muitos fabricantes integram contadores de desempenho de hardware, que permitem o monitoramento em tempo real de aspectos como falhas de cache, previsões de desvio com falha, acessos específicos à memória e assim por diante. Quando usados corretamente, esses contadores são uma ferramenta poderosa tanto para otimizar o desempenho quanto para encontrar padrões anômalos característicos de malware ou exploits avançados, mesmo em arquiteturas parcialmente assíncronas.
Virtualização, vCPU e isolamento em ambientes modernos
Outro ingrediente fundamental no cenário atual é a virtualização. Na nuvem, trabalhamos constantemente com CPUs virtuais (vCPUs) , que são blocos lógicos de poder de processamento alocados a máquinas virtuais ou contêineres sobre hardware físico compartilhado.
Cada vCPU é essencialmente um conjunto de threads ou tempos de execução que o hipervisor agenda nos núcleos físicos da CPU. Para que isso funcione corretamente, a CPU física oferece modos privilegiados especiais que permitem aos hipervisores criar e isolar máquinas virtuais , interceptar certas instruções sensíveis e gerenciar a memória de cada host sem que eles interfiram ou espionem uns aos outros.
Nesse contexto, segurança sem clock significa que a alocação de tempo de CPU entre máquinas virtuais não depende exclusivamente de um clock uniforme, mas sim de mecanismos de agendamento mais dinâmicos, baseados em hardware . O hipervisor ainda vê os ciclos de clock, mas a forma como esses ciclos se traduzem em trabalho efetivo em cada núcleo pode ser alterada por blocos assíncronos internos.
Do ponto de vista da segurança, isso exige o desenvolvimento de ferramentas de monitoramento que não se limitem a contar ciclos de acesso, mas que também possam ler contadores de desempenho, estatísticas de uso e eventos de baixo nível para detectar abuso de recursos, escapes de máquinas virtuais ou padrões irregulares que indiquem uma intrusão.
Além disso, em ambientes com uso intensivo de computação, onde unidades vetoriais, GPUs e outros aceleradores são utilizados em todo o seu potencial, os gestores de segurança devem considerar que esses blocos, sejam síncronos ou assíncronos, podem se tornar ferramentas para acelerar ataques criptográficos, minerar criptomoedas sem o conhecimento do usuário ou analisar grandes volumes de dados roubados.
Desempenho, consumo de energia e overclocking em comparação com um design sem clock.
Por fim, devemos considerar a relação entre desempenho e consumo de energia. Aumentar a frequência do clock por meio de overclock (por exemplo, realizando um teste de estabilidade com o OCCT ) permite que uma CPU execute mais operações por segundo , mas, em contrapartida, aumenta significativamente seu consumo de energia e temperatura. De fato, muitos processadores atuais já ajustam dinamicamente sua frequência e voltagem de acordo com a carga de trabalho e a temperatura interna.
Os projetos assíncronos oferecem uma alternativa: em vez de usar um clock muito rápido e tentar manter tudo em fase, eles permitem que cada bloco opere no ritmo ditado pelos dados . Durante períodos de baixa carga, as partes inativas praticamente não mudam de estado, reduzindo o consumo de energia sem a necessidade de mecanismos complexos de gerenciamento de energia baseados em clock.
Do ponto de vista da segurança, menor consumo de energia e menos calor não se resumem apenas ao meio ambiente ou às contas de luz. Significam também menos desgaste dos componentes , menor probabilidade de falhas causadas por eletromigração ou fuga de corrente e, potencialmente, menor exposição a ataques que tentam explorar o comportamento do sistema sob condições extremas de temperatura ou tensão.
No entanto, projetar um sistema totalmente assíncrono e seguro não é trivial. Requer uma verificação muito rigorosa dos protocolos de comunicação entre blocos, condições de corrida e estados intermediários para evitar comportamentos não determinísticos que poderiam ser explorados por um atacante . A complexidade do projeto, a escassez de ferramentas maduras e a necessidade de compatibilidade com versões anteriores de software fizeram com que, por enquanto, a maioria dos processadores comerciais permaneça predominantemente síncrona, com pequenas ilhas assíncronas.
A combinação de todos esses fatores — arquitetura interna, gerenciamento de clock, paralelismo, virtualização e consumo de energia — torna a segurança em ambientes sem um clock global um equilíbrio delicado. Projetos assíncronos mitigam certos ataques baseados em temporização e facilitam estratégias de economia de energia altamente refinadas, mas também apresentam novos desafios para o monitoramento, auditoria e verificação do comportamento do hardware. Portanto, a chave está na integração de mecanismos robustos de observabilidade e isolamento desde o nível do silício até o software de mais alto nível.


Escritor apaixonado pelo mundo dos bytes e da tecnologia em geral. Adoro compartilhar meu conhecimento por meio da escrita, e é isso que farei neste blog, mostrar a vocês tudo o que há de mais interessante sobre gadgets, software, hardware, tendências tecnológicas e muito mais. Meu objetivo é ajudá-lo a navegar no mundo digital de uma forma simples e divertida.
Índice
- 1 A CPU como centro do sistema e sua relação com o relógio.
- 2 Da fiação fixa aos microprocessadores integrados
- 3 Componentes internos essenciais de uma CPU moderna
- 4 Como executar um programa passo a passo
- 5 Paralelismo, canalização e execução fora de ordem.
- 6 O papel da frequência do relógio e seus limites físicos
- 7 O que entendemos por segurança sem relógio de ponto?
- 8 Representação de dados, tamanho da palavra e segurança
- 9 Paralelismo massivo, multithreading e vetores: impacto na segurança sem clock.
- 10 Virtualização, vCPU e isolamento em ambientes modernos
- 11 Desempenho, consumo de energia e overclocking em comparação com um design sem clock.