- Html Agility Pack muliggjør robust parsing og spørring av HTML med XPath/LINQ.
- PowerShell og C# dekker statisk skraping; Selenium løser sider med JavaScript.
- CsvHelper og IronPDF gjør det enkelt å eksportere data til CSV eller generere rapporter i PDF.
- Bruk av proxyer reduserer blokkeringer og muliggjør regionalt fokusert skraping.
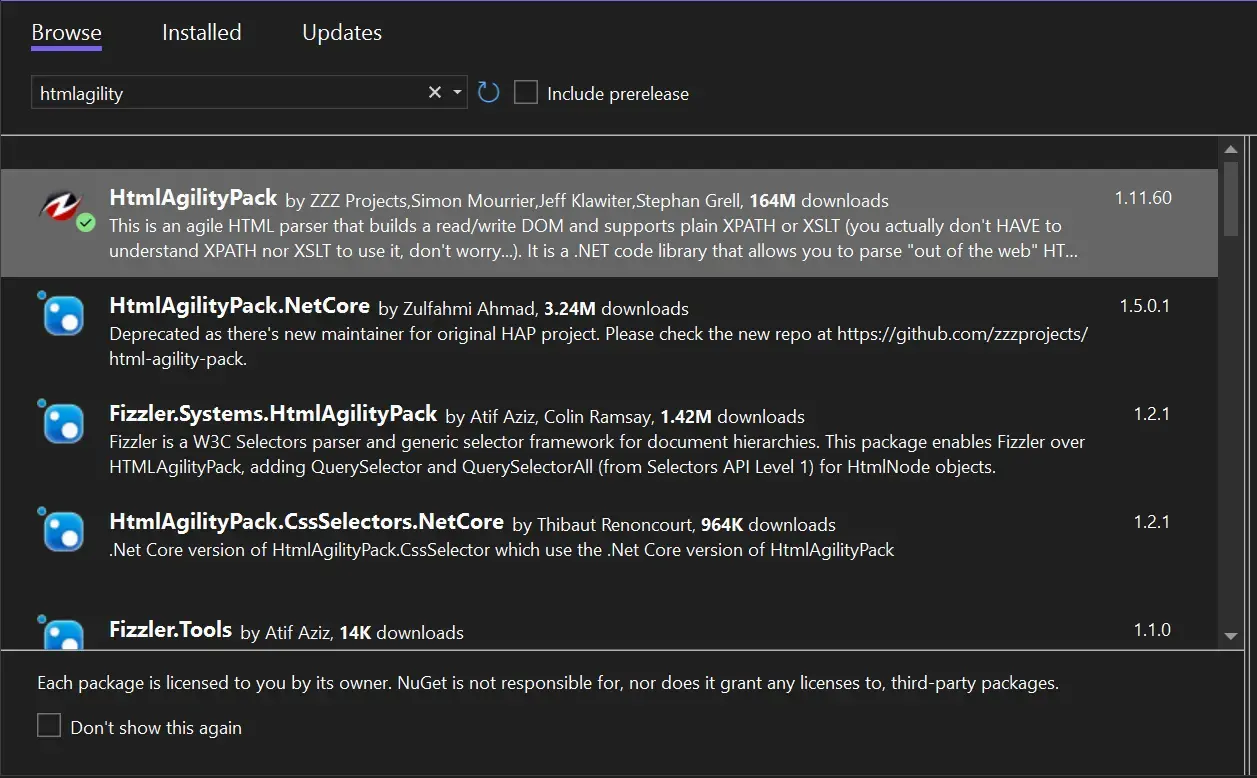
Hvis du leter etter en praktisk måte å trekke ut strukturerte data uten å bli hengende fast i regulære uttrykk, er det å kombinere PowerShell med HTML Agility Pack en av de tidsbesparende og frustrerende løsningene. Denne stakken lar deg navigere i DOM, finne noder ved hjelp av XPath eller LINQ, og lese tekst, attributter eller HTML pålitelig, selv når markupen ikke er perfekt.
I de følgende linjene kombinerer vi det beste fra flere tilnærminger: PowerShell, C# og Selenium for å dekke statisk og dynamisk innhold, eksempler fra den virkelige verden (som å trekke ut annonsetekst fra Craigslist), CSV-eksport og til og med muligheten til å konvertere resultater til PDF med IronPDF. Alt dette ledsages av nyttige tips som bruk av proxyer for å unngå blokkering og anbefalinger for å sikre at selektorene dine forblir robuste over tid.
Hva er HTML Agility Pack, og hvorfor er det så nyttig?
HTML Agility Pack (HAP) er et .NET-bibliotek som analyserer HTML til et tre av noder som du kan navigere i, spørre og manipulere. I motsetning til andre, mer sårbare tilnærminger, tolererer HAP dårlig formatert HTML og lar deg bevege deg gjennom DOM-en ved hjelp av XPath eller LINQ med et enkelt API.
Styrkene inkluderer: tilgivende parsing (den håndterer ufullkommen HTML), DOM-manipulering (legge til, slette eller endre noder/attributter), kompatibilitet med XPath og LINQ , og god ytelse selv med store dokumenter. Videre er designet utvidbart, slik at du kan implementere tilpassede filtre eller behandlere etter behov.
Last inn og analyser HTML med HAP: fil, streng eller web
For å begynne kan du laste inn HTML-innhold fra en lokal fil, en streng i minnet eller direkte fra en URL. Nøkkelklassen er HtmlDocument , og for webutvikling er det veldig praktisk å bruke HtmlWeb og Load()-metoden.
// Desde archivo
var doc = new HtmlDocument();
doc.Load(filePath);

// Desde cadena
var doc2 = new HtmlDocument();
doc2.LoadHtml(htmlString);

// Desde la web
var web = new HtmlWeb();
var doc3 = web.Load("http://example.com/");
Når dokumentet er lastet inn, får du tilgang til rotnoden ved hjelp av DocumentNode . Derfra kan du velge noder ved hjelp av XPath eller LINQ, og enkelt lese egenskaper som OuterHtml, InnerText, Name eller attributtsamlingen.
Valg og lesing av noder: XPath, attributter og tekstrensing
Med XPath kan du finne bestemte elementer uten å måtte bry deg med HTML. Biblioteket tilbyr SelectSingleNode() for ett enkelt resultat og SelectNodes() når du forventer flere resultater.
// Un solo nodo (por ejemplo, el <title> de la página)
var titleNode = doc.DocumentNode.SelectSingleNode("//head/title");

// Varios nodos (por ejemplo, todos los <article>)
var articles = doc.DocumentNode.SelectNodes("//article");

// Lectura de información útil
var name = titleNode.Name;            // etiqueta del nodo
var html = titleNode.OuterHtml;       // HTML completo del nodo
var text = titleNode.InnerText;       // texto plano del nodo
Når tekst inneholder HTML-enheter, kan du «rense» innholdet ved hjelp av verktøy som HtmlEntity.DeEntitize() eller, hvis du foretrekker BCL, System.Net.WebUtility.HtmlDecode() . Dette returnerer mer naturlig tekst, klar til å bli behandlet som data.
// Limpieza de entidades HTML en texto extraído
var limpio = HtmlEntity.DeEntitize(titleNode.InnerText);
// o
var limpio2 = System.Net.WebUtility.HtmlDecode(titleNode.InnerText);
PowerShell + HTML Agility Pack: Inspeksjon, metoder og utvinning fra den virkelige verden
Mange team foretrekker PowerShell fordi det gir mulighet for veldig raske prototyper for webskraping. Du kan laste inn HAP DLL-en (for eksempel versjon 1.11.59 ) og bruke klassene fra skript. Hvis du har jobbet med moduler som PSarseHTML, brukte du faktisk HAP under panseret.
# Cargar la DLL (ajusta la ruta a tu entorno)
$hapPath = 'C:\ruta\a\HtmlAgilityPack.dll'
[Reflection.Assembly]::LoadFile($hapPath) | Out-Null

# Descargar una página y cargarla en HtmlDocument
$dest = '$env:TEMP\page.htm'
$wc = New-Object System.Net.WebClient
$wc.Credentials = [System.Net.CredentialCache]::DefaultNetworkCredentials
$wc.DownloadFile('http://localhost/mihtml.html', $dest)

$doc = New-Object HtmlAgilityPack.HtmlDocument
$doc.Load($dest)
$root = $doc.DocumentNode

# Por ejemplo, recorrer filas de una tabla
$rows = $root.Descendants('tr')
foreach ($row in $rows) {
    $cells = $row.Descendants('td')
    if ($cells.Count -ge 2) {
        Write-Host ($cells[0].InnerText + ' - ' + $cells[1].InnerText)
    }
}
Et vanlig spørsmål når man utforsker objekter i PowerShell er hvor `GetAttributeValue()` kommer fra og hvorfor flere signaturer vises. I HtmlAgilityPack eksponerer nodene denne metoden med overbelastninger som aksepterer attributtnavnet og en standardverdi for å konvertere til string, int, bool osv. PowerShell kan vise den som en generisk metode (T) eller flere overbelastninger avhengig av skrivemotoren, men for praktiske formål bruker du den slik:
# Obtener un atributo (con valor por defecto si no existe)
$href = $node.GetAttributeValue('href', $null)
$tabIndex = $node.GetAttributeValue('tabindex', -1)
$esActivo = $node.GetAttributeValue('data-active', $false)
Regex for HTML? Bedre ikke. Hvis du vil trekke ut brødteksten til en annonse pakket inn i en `<section>` med en spesifikk ID, er det mer stabilt å bruke XPath enn å slite med sårbare mønstre. For eksempel, i et tilfelle som `<section id='posting body'>…</section>`:
# Seleccionar el <section> por id (incluso si hay espacios en el id)
$section = $root.SelectSingleNode("//section[@id='posting body']")
if ($section) {
    $texto = $section.InnerText
}
Denne tilnærmingen er ren og vedlikeholdbar: hvis strukturen endres, justerer du XPath , og så er du ferdig. Du unngår typiske feil i vanlig HTML (nesting, mellomrom, attributter i ulik rekkefølge osv.).
En rask titt med VB.NET og et annet eksempel i PowerShell
Den samme ideen gjelder i VB.NET eller C#: vi laster ned HTML-koden, laster den inn i HtmlDocument , finner rader og celler og trekker ut teksten deres med svært lite kode.
' VB.NET: recorrer una tabla simple
Using client As New Net.WebClient()
    Dim tmp = IO.Path.GetTempFileName()
    client.Credentials = CredentialCache.DefaultNetworkCredentials
    client.DownloadFile(_URL, tmp)

    Dim doc = New HtmlAgilityPack.HtmlDocument()
    doc.Load(tmp)

    Dim root = doc.DocumentNode
    Dim filas = root.Descendants("tr").ToList()

    For Each fila In filas
        Dim tds = fila.Descendants("td").ToList()
        If tds.Count >= 2 Then
            Console.WriteLine(tds(0).InnerText & ": " & tds(1).InnerText)
        End If
    Next
End Using
Som du kan se, tilbyr HAP en robust og allsidig parsemotor . Forskjellen mellom språkene ligger i syntaksen; arbeidsflyten er identisk: last inn, velg noder og les innhold.
Statisk skraping i C# trinn for trinn: fra XPath til CSV
På nettsteder med statisk innhold (HTML-koden inneholder allerede dataene), laster du bare ned siden og analyserer nodene. La oss se på en komplett arbeidsflyt: installer HAP, last inn en side, velg rader ved hjelp av XPath, tilordne til objekter og eksporter til CSV med CsvHelper.
1) Installer HtmlAgilityPack fra NuGet. 2) Last inn URL-en ved hjelp av HtmlWeb.Load(). 3) Hent nodene ved hjelp av XPath. 4) Trekk ut teksten fra hver celle. 5) Eksporter objektene til CSV ved hjelp av CsvHelper.
using HtmlAgilityPack;
using System.Collections.Generic;

// URL de ejemplo (Wikipedia)
var url = "https://en.wikipedia.org/wiki/List_of_SpongeBob_SquarePants_episodes";
var web = new HtmlWeb();
var document = web.Load(url);

// XPath que selecciona filas de las tablas de episodios
var nodes = document.DocumentNode.SelectNodes(
    "//*[@id='mw-content-text']/div[1]/table[position()>1 and position()<15]/tbody/tr[position()>1]");

// Clase para mapear resultados
public class Episode {
    public string OverallNumber { get; set; }
    public string Title { get; set; }
    public string Directors { get; set; }
    public string WrittenBy { get; set; }
    public string Released { get; set; }
}

var episodes = new List<Episode>();
foreach (var node in nodes) {
    episodes.Add(new Episode {
        OverallNumber = HtmlEntity.DeEntitize(node.SelectSingleNode("th[1]").InnerText),
        Title        = HtmlEntity.DeEntitize(node.SelectSingleNode("td[2]").InnerText),
        Directors    = HtmlEntity.DeEntitize(node.SelectSingleNode("td[3]").InnerText),
        WrittenBy    = HtmlEntity.DeEntitize(node.SelectSingleNode("td[4]").InnerText),
        Released     = HtmlEntity.DeEntitize(node.SelectSingleNode("td[5]").InnerText)
    });
}
For å skrive CSV-filen forenkler CsvHelper utdataene betraktelig. Du oppretter ganske enkelt en StreamWriter og kaller WriteRecords() med den sterkt typede listen din.
using CsvHelper;
using System.Globalization;
using System.IO;

using (var writer = new StreamWriter("output.csv"))
using (var csv = new CsvWriter(writer, CultureInfo.InvariantCulture)) {
    csv.WriteRecords(episodes);
}
På denne måten kan hvem som helst åpne CSV-filen i Excel og jobbe med de strukturerte dataene uten å berøre noen kode. Det er en enkel og pålitelig arbeidsflyt som er lett å vedlikeholde hvis sidestrukturen endres: bare oppdater XPath-filen din, så er du klar.
Når HTML ikke bringer dataene: dynamisk, AJAX og Selenium
På dynamiske nettsteder kan den første HTML-koden være tom, og JavaScript gjengir dataene etter XHR-forespørsler. Siden HAP ikke kjører JavaScript , trenger du en headless nettleser som Selenium for å gjengi dataene først og deretter trekke dem ut.
using OpenQA.Selenium;
using OpenQA.Selenium.Chrome;

var url = "https://en.wikipedia.org/wiki/List_of_SpongeBob_SquarePants_episodes";
var chromeOptions = new ChromeOptions();
chromeOptions.AddArguments("headless");
var driver = new ChromeDriver(chromeOptions);

driver.Navigate().GoToUrl(url);

var rows = driver.FindElements(By.XPath(
    "//*[@id='mw-content-text']/div[1]/table[position()>1 and position()<15]/tbody/tr[position()>1]"));

foreach (var row in rows) {
    var title = row.FindElement(By.XPath("td[2]")).Text;
    // ...
}
I scenarier med lat lasting eller trege forespørsler, legg til en WebDriverWait for å vente på at noder skal vises eller at Ajax-forespørselen skal fullføres. Det er mer ressurskrevende enn HAP, men for dynamiske sider er det riktig tilnærming.
HAP-nøkkelbegrensning og WebView-alternativ
HAP analyserer DOM-en når den kommer fra serveren; det vil si at den ikke kjører JavaScript . Hvis målnettstedet ditt krever skript for å gjengi innholdet, kan du i tillegg til Selenium laste inn siden i en WebView/WebBrowser- kontroll som kjører JavaScript, og når den er klar, sende den resulterende HTML-koden til HtmlAgilityPack. På denne måten kombinerer du sanntidsgjengivelse med robust parsing.
Brukstilfeller: hva skal man gjøre med dataene
Når du har objektene dine i minnet, er den eneste grensen fantasien din: lagre dem i en database, konverter dem til JSON for å aktivere API-er, generer CSV-filer for forretningsteamet, eller inkluder dem i vanlige rapporter. Nøkkelen er å oversette resultatene til formater som organisasjonen din allerede bruker.
Personvern, blokkering og regional skraping ved bruk av proxyer
Når nettsteder scraper i stor skala, kan de oppdage mønstre og blokkere IP-adressen din . Bruk av proxyer (helst de med roterende adresser) bidrar til å unngå blokkeringer, fordeler belastningen og gir tilgang til regionale versjoner av samme nettsted. En god leverandør lar deg velge din exit-lokasjon, ideelt for markedsundersøkelser eller internasjonal prising.
Roterende proxyer tildeler forskjellige IP-adresser for hver forespørsel, noe som gjør det vanskeligere for anti-bot-systemer å spore dem. Hvis du i tillegg trenger å se kataloger eller priser som varierer fra land til land, kan du velge proxy-plasseringen for å få den nøyaktige visningen en ekte bruker i den regionen ville se.
Integrer HtmlAgilityPack med IronPDF: Fra HTML til PDF
Det finnes scenarier der du må pakke resultater inn i et dokument. Det er her IronPDF kommer inn i bildet: med HAP trekker du ut og skriver ønsket HTML-kode, og med IronPDF konverterer du den til PDF samtidig som du bevarer stiler og layout. Det er perfekt for rapporter eller leveranser som deles utenfor det tekniske teamet.
Det er like enkelt å installere IronPDF som å legge til NuGet-pakken. Alternativt kan du integrere DLL-filen manuelt . Når den er referert, oppretter du en HtmlToPdf og gjengir en HTML-streng som du genererer selv fra de skrapede dataene.
using HtmlAgilityPack;
using System.Text;
// using IronPdf;  // Asegúrate de referenciar IronPDF

var web = new HtmlWeb();
var doc = web.Load("https://ironpdf.com/");

var nodes = doc.DocumentNode.SelectNodes(
    "//h1[@class='product-homepage-header product-homepage-header--ironpdf']");

var htmlContent = new StringBuilder();
foreach (var n in nodes) {
    htmlContent.Append(n.OuterHtml);
}

var renderer = new IronPdf.HtmlToPdf();
var pdf = renderer.RenderHtmlAsPdf(htmlContent.ToString());
pdf.SaveAs("output.pdf");
Hvis du trenger å legge til topptekster, bunntekster, nummerering eller skrive sider med seksjoner hentet fra forskjellige URL-er, kan du tilpasse resultatet før du sender det til PDF- motoren for et mer polert resultat.
God praksis for selektorer og vedlikehold
- Foretrekk stabile attributter (meningsfulle ID-er eller klasser) fremfor skjøre indekser som div[3]/span[2].
- Unngå regex i HTML når det finnes et DOM/XPath-alternativ.
- Bruk HtmlEntity.DeEntitize/HtmlDecode for å rydde opp i enheter.
- Sentraliser XPath-er til konstanter og dokumenter hensikten deres.
- Implementerer feilkontroller: nullnoder, tidsavbrudd, strukturelle endringer.
- For dynamikk, legg til eksplisitte ventetider og betingelser for elementtilstedeværelse.
Det er også lurt å registrere ekte HTML-eksempler i tester for å oppdage brudd når nettstedet endres. Å vedlikeholde en liten testpakke for XPathene og mappingene dine er rimelig og forhindrer problemer i produksjonen, spesielt når det er flere datakilder.
Tips for ytelse og utvidbarhet
HAP er optimalisert for håndtering av store dokumenter med rimelig minneforbruk. Likevel, hvis du skal behandle mange sider, bør du vurdere å parallellisere nedlastinger med begrensninger (f.eks. SemaphoreSlim ) og normalisere HTML-koden rett før utpakking. Hvis du trenger spesielle regler, kan du utvide pipelinen med dine egne filtre før du bygger objektene dine.
I blandede miljøer er PowerShell ideelt for å orkestrere oppgaver (nedlastinger, proxy-rotasjon, kjøring av kompilerte C# -parsere ) og konsolidering av resultater. Kombinasjon av skript med .NET-verktøy gir deg smidighet uten at det går på bekostning av ytelse.
Hvis du bruker regulære uttrykk, vil du legge merke til at DOM/XPath krever mindre vedlikehold og gir mye større lesbarhet. En godt designet selektor kan vanligvis overleve i flere måneder, selv med mindre justeringer av markupen på målnettstedet.
Hele dette økosystemet (HtmlAgilityPack for analyse, Selenium for gjengivelse om nødvendig, CsvHelper for eksport og IronPDF for presentasjon) integreres sømløst med virkelige utvinnings- og rapporteringsarbeidsflyter. Med PowerShell, C# eller VB.NET kan du bygge skalerbare løsninger og, med støtte fra proxyer , operere mer robust i møte med krasj, regionale endringer eller belastningstopper.
Indeks
- 1 Hva er HTML Agility Pack, og hvorfor er det så nyttig?
- 2 Last inn og analyser HTML med HAP: fil, streng eller web
- 3 Valg og lesing av noder: XPath, attributter og tekstrensing
- 4 PowerShell + HTML Agility Pack: Inspeksjon, metoder og utvinning fra den virkelige verden
- 5 En rask titt med VB.NET og et annet eksempel i PowerShell
- 6 Statisk skraping i C# trinn for trinn: fra XPath til CSV
- 7 Når HTML ikke bringer dataene: dynamisk, AJAX og Selenium
- 8 HAP-nøkkelbegrensning og WebView-alternativ
- 9 Brukstilfeller: hva skal man gjøre med dataene
- 10 Personvern, blokkering og regional skraping ved bruk av proxyer
- 11 Integrer HtmlAgilityPack med IronPDF: Fra HTML til PDF
- 12 God praksis for selektorer og vedlikehold
- 13 Tips for ytelse og utvidbarhet
