- 로컬 AI는 인터넷 연결 없이도 기밀 데이터를 처리할 수 있어 완벽한 개인 정보 보호를 보장하고 API 비용을 절감합니다.
- 맥에서의 성능은 GPU의 VRAM 또는 통합 메모리에 크게 좌우되며, Ollama와 LM Studio가 가장 쉽게 접근할 수 있는 도구입니다.
- Llama, Mistral, Phi와 같은 다양한 오픈 소스 모델들이 있으며, 이 모델들은 양자화를 통해 다양한 하드웨어 기능에 적응합니다.
아마 여러분도 이런 경험이 있을 겁니다. 인공지능을 활용해 업무를 효율적으로 처리하고 싶지만, 개인 정보가 원격 서버에 저장될지도 모른다는 생각에 불안감을 느끼는 거죠. 특히 진정한 프라이버시와 완벽한 통제를 이야기할 때 , 대화 내용이나 기밀 문서가 해킹으로 유출되거나 법원 명령에 따라 제출될 수 있다는 생각은 많은 사람들을 밤잠 못 이루게 합니다.
다행스러운 점은 이제 집에서 자신만의 AI를 구축하기 위해 컴퓨터 전문가가 될 필요가 없다는 것입니다. 오늘날에는 괜찮은 컴퓨터만 있으면 누구나 로컬 언어 모델을 실행할 수 있게 되었으며, 덕분에 월 사용료와 인터넷 연결 비용 없이 PC를 누구에게도 정보를 유출하지 않는 개인용 디지털 두뇌로 만들 수 있게 되었습니다.

로컬 AI를 갖는다는 것은 실제로 무엇을 의미할까요?
로컬 AI란 질문을 작성하는 것부터 모델이 답변을 생성하는 전체 과정이 사용자의 하드웨어 내에서 이루어지는 것을 의미합니다 . 외부 API 호출이나 네트워크를 통한 토큰 전송이 없으며, 모델 가중치 계산과 추론은 사용자의 GPU 또는 CPU에서 처리됩니다. 이는 독점 코드, 의료 기록 , 또는 GDPR과 같이 엄격한 규정을 준수해야 하는 데이터를 관리하는 기업, 특히 EU 외부로 데이터를 전송하는 것이 법적 문제로 골칫거리인 기업에게 혁신적인 변화를 가져올 것입니다.
물론 장단점이 있습니다. 폐쇄형 클라우드 모델이 복잡한 추론 분야에서 선두를 달리고 있는 반면, 오픈 소스 모델도 비약적으로 발전했습니다. 텍스트 요약, 로컬 AI를 사용한 비디오 자동 전사 , 파이썬 프로그래밍, 콘텐츠 번역과 같은 일상적인 작업은 놀라운 품질로 로컬에서 수행할 수 있으며, 일단 장비를 확보하면 사용 비용이 전혀 들지 않는다는 장점도 누릴 수 있습니다.
하드웨어: 인공지능의 연료
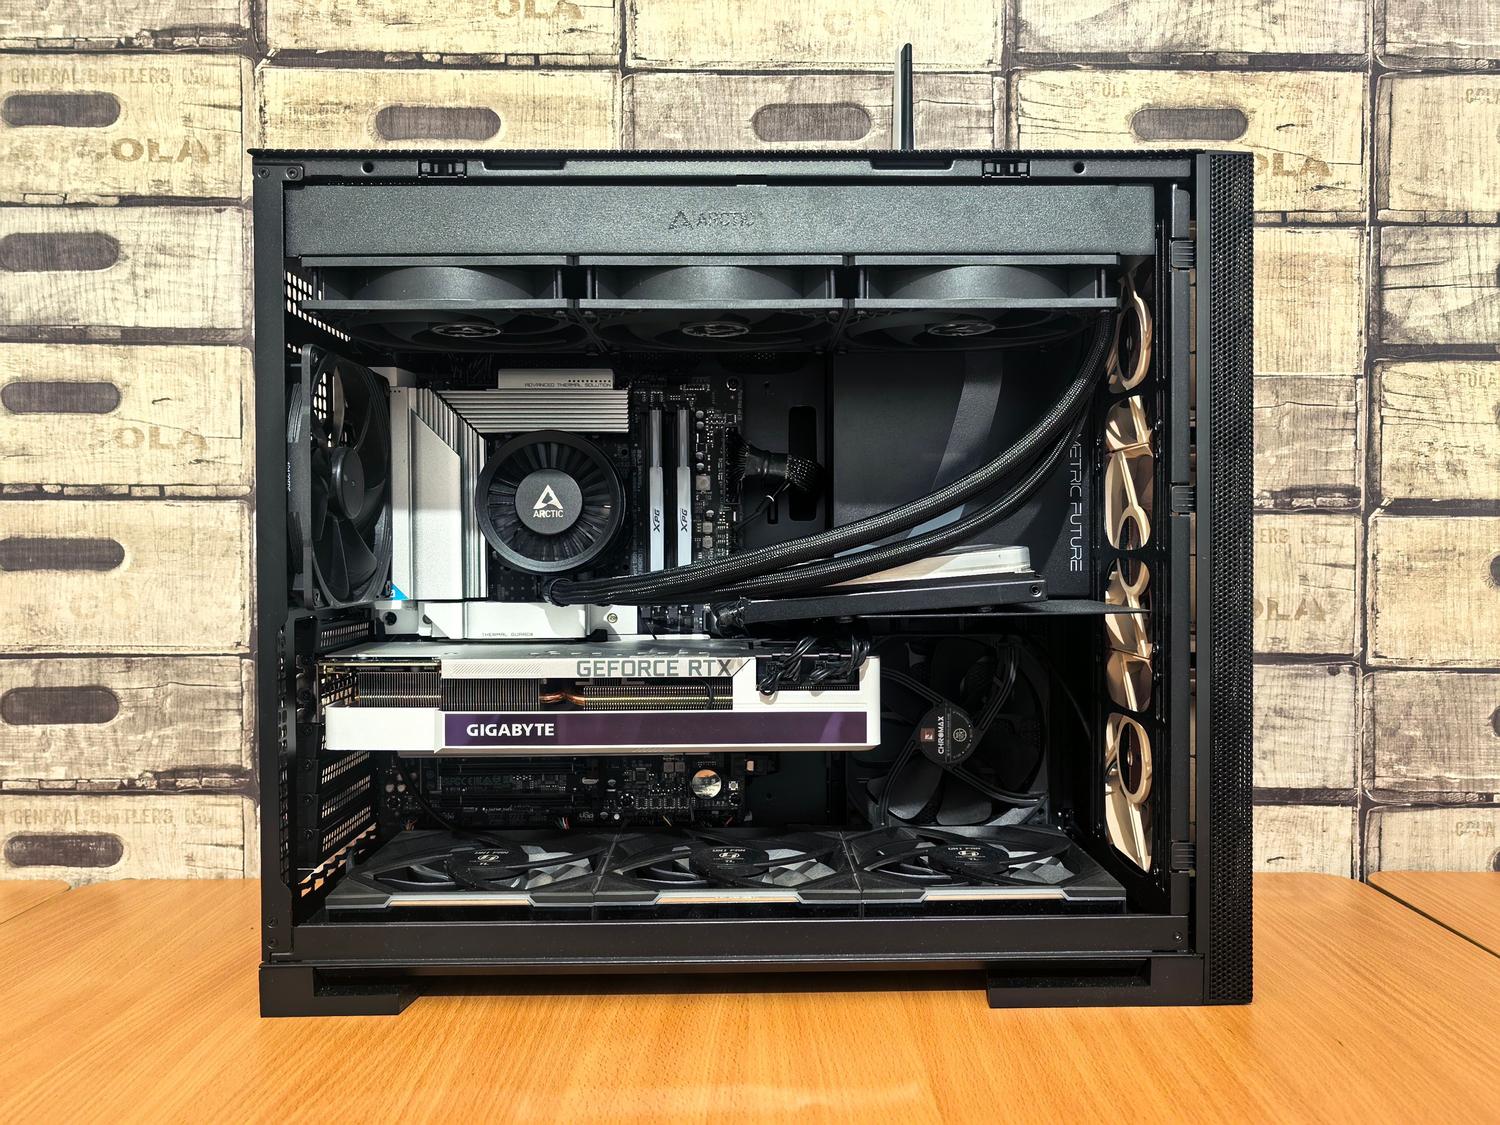
AI의 성능 저하를 방지하려면 프로세서보다는 사용 가능한 메모리가 핵심 요소입니다. LLM은 RAM과 VRAM을 엄청나게 많이 사용합니다. 통합 메모리 아키텍처 (M1, M2, M3 또는 M4 칩)를 사용하는 Mac을 사용하는 경우, GPU가 시스템의 모든 RAM에 접근할 수 있으므로 더 큰 모델을 더 적은 노력으로 실행할 수 있다는 큰 이점이 있습니다.
- 맥 컴퓨터: 16GB RAM을 탑재한 모델은 8비트 게임을 원활하게 실행할 수 있습니다. 64GB 이상으로 업그레이드하면 70비트 게임까지 플레이할 수 있어 프리미엄 서비스 수준의 성능을 경험할 수 있습니다.
- Windows/Linux 운영체제를 사용하는 PC: 여기서, 그래픽 카드 VRAM12GB RTX 3060 또는 16GB RTX 4060 Ti가 이상적인 입문용 그래픽 카드입니다. 24GB RTX 4090을 사용한다면, 시스템 충돌 없이 가벼운 양자화 기능을 활용하여 매우 강력한 그래픽 카드를 실행할 수 있습니다.
- 저렴한 옵션: 전용 GPU가 없다면 CPU를 사용할 수 있지만, 상당한 대기 시간이 발생할 수 있습니다. 속도 차이는 엄청납니다. GPU는 몇 초 안에 응답을 생성할 수 있는 반면, CPU 추론 단락당 30초 정도 걸릴 수 있습니다.

모델 설치 및 실행을 위한 주요 도구
더 이상 CUDA 종속성이나 PyTorch 버전 충돌 문제로 씨름할 필요가 없습니다. 이러한 번거로운 작업을 대신 처리해주는 도구들이 있습니다.
올라마: 효율적인 엔진
Ollama는 간편함을 추구하는 사람들에게 표준으로 자리 잡았습니다. 기본적으로 명령줄 기반의 추론 런타임 입니다 . 자체적인 시각적 인터페이스는 없지만, 놀라울 정도로 가볍습니다. ` ollama run llama3` 와 같은 간단한 명령어로 모델을 실행할 수 있으며, OpenAI 호환 API를 제공하여 다양한 외부 애플리케이션과 연결할 수 있습니다.
LM 스튜디오와 얀: 시각적 경험
명령줄 도구 사용이 번거롭다면 LM Studio를 설치하고 설정하는 것이 가장 깔끔한 방법입니다. LM Studio는 시각적인 카탈로그를 제공하여 평점이 높은 모델을 한눈에 확인하고 클릭 한 번으로 다운로드할 수 있습니다. 또한 Mac에서는 Apple의 MLX 엔진을 활용하여 뛰어난 성능을 제공합니다. 반면 Jan은 순수 오픈 소스 대안으로 , 단일 인터페이스에서 로컬 모델과 클라우드 API를 자유롭게 전환할 수 있어 코드 투명성을 중시하는 사용자에게 적합합니다.

마이크로소프트 파운드리와 윈도우 ML
Windows 애플리케이션 개발자를 위해 Microsoft는 로컬 AI를 소프트웨어에 통합하도록 설계된 솔루션인 Foundry를 제공합니다. Foundry를 사용하면 사용자는 1시간 이내에 바로 사용할 수 있는 모델을 만들 거나 Windows ML을 통해 Hugging Face에서 다른 모델을 가져올 수 있으며, DirectML을 통한 하드웨어 가속을 활용하여 장치의 GPU 또는 NPU를 최대한 활용할 수 있습니다.
추천 모델 및 선택 방법
모든 모델이 모든 용도에 적합한 것은 아닙니다. 선택은 하드웨어와 달성하고자 하는 목표에 따라 달라집니다. 양자화 (Q4, Q5, Q8)를 이해하는 것이 중요한데, 이는 기본적으로 약간의 정밀도를 희생하여 메모리 사용량을 줄이기 위해 모델을 압축하는 과정입니다.
- 통화 3 / 통화 4: Meta의 고성능 모델들입니다. 복잡한 추론과 전문적인 글쓰기에 이상적입니다. 70B 모델은 엄청난 성능을 자랑하지만, 많은 VRAM을 필요로 합니다.
- 미스트랄과 믹스트랄: 완벽한 균형. 미스트랄 7B는 아마도 최고의 추천 대부분의 경우 속도와 경쟁력 때문에 인기가 있습니다.
- Phi(마이크로소프트)와 Gemma(구글): 보다 가볍고 최적화된 모델은 자원이 제한적인 기계나 간단한 분류 작업에 적합합니다.
- 딥시크: 프로그래밍 및 논리적 추론 작업에서 매우 강력한 성능을 발휘하며, 가장 가벼운 버전부터 엔터프라이즈급 하드웨어가 필요한 대규모 모델까지 다양한 버전이 있습니다.
일상 생활에 유용한 실용적인 워크플로
모델을 설치하는 것은 시작에 불과합니다. 진정한 마법은 모델을 일상 업무에 통합할 때 일어납니다. Cherry Studio나 Levante 같은 클라이언트를 사용하여 채팅 기록을 관리하고, 동일한 대화 내에서 로컬 모델(민감한 데이터용)과 클라우드 기반 모델(매우 복잡한 작업용)을 전환할 수 있습니다.
전문적인 환경에서 이 기능을 사용하면 계약서나 의료 보고서와 같은 기밀 문서를 처리하고 , 요약하거나 핵심 정보를 추출하는 등 모든 작업을 사무실 밖으로 데이터 전송 없이 수행할 수 있습니다. 또한 ComfyUI 와 같은 도구를 사용하여 오프라인 이미지 생성 워크플로를 구축함으로써 Midjourney와 같은 서비스에 대한 의존도를 줄이고 디자인의 지적 재산권을 보호할 수 있습니다.
과감하게 도전해보고 싶은 분들은 간단히 Ollama를 설치하고, 사용 가능한 RAM 용량에 따라 Mistral이나 Llama 같은 모델을 선택한 후 채팅을 시작하면 됩니다. 폐쇄형 시스템이 순수 AI 측면에서 여전히 약간 우위에 있지만, 개인 정보 보호, 무료 비용, 그리고 제어 기능을 모두 갖춘 로컬 AI는 개인 정보를 중시하고 자신의 컴퓨터에서 제한 없이 실험하고 싶은 모든 사용자에게 가장 현명한 선택입니다.


바이트와 기술 전반에 관한 세계에 대한 열정적인 작가입니다. 나는 글쓰기를 통해 내 지식을 공유하는 것을 좋아하며 이것이 바로 이 블로그에서 할 일이며 가젯, 소프트웨어, 하드웨어, 기술 동향 등에 관한 가장 흥미로운 모든 것을 보여 드리겠습니다. 제 목표는 여러분이 간단하고 재미있는 방식으로 디지털 세계를 탐색할 수 있도록 돕는 것입니다.