- I dati duplicati distorcono analisi e decisioni, quindi è fondamentale individuarli e controllarli prima di utilizzarli.
- I fogli di calcolo come Excel consentono di evidenziare, filtrare e rimuovere i duplicati combinando formattazione condizionale, filtri avanzati e funzioni di testo.
- En database SQL, SELECT DISTINCT e alternative come GROUP BY aiutano a ottenere risultati senza righe ripetute e senza modificare i dati originali.
- Gli strumenti di gestione bibliografica e le buone pratiche di backup e di revisione preliminare riducono il rischio di perdere informazioni rilevanti eliminando i duplicati.
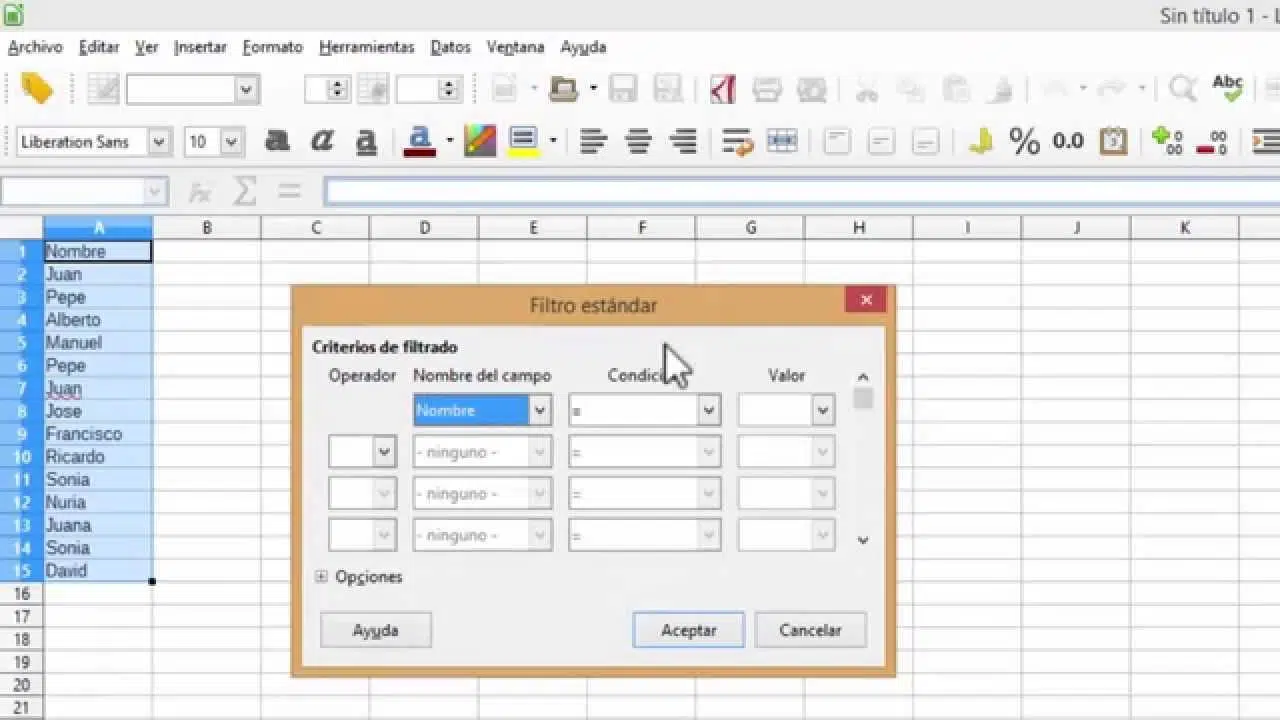
Quando si lavora con database, fogli di calcolo o sistemi informativi, i dati duplicati possono diventare un vero grattacapo . Record ripetuti, nomi scritti in innumerevoli modi diversi, date formattate male o spazi superflui rendono le analisi inaffidabili e fanno perdere tempo a rivedere manualmente ciò che il sistema potrebbe correggere in pochi secondi.
La buona notizia è che esistono potenti strumenti per individuare, evidenziare e rimuovere i dati duplicati in Excel, Fogli Google , database SQL e sistemi di gestione bibliografica. Comprendere come funzionano questi strumenti, le loro differenze e i rischi connessi (come la cancellazione di informazioni di cui ci si potrebbe pentire in seguito) è fondamentale per mantenere i dati organizzati e analizzarli in modo efficace.
Perché compaiono dati duplicati e perché rappresentano un problema?
In pratica, i duplicati derivano da errori umani, importazioni ripetute o sistemi scarsamente coordinati . Moduli inviati due volte, file uniti senza una preventiva pulizia o integrazioni tra applicazioni che non convalidano correttamente le informazioni creano il terreno fertile ideale per la creazione di record duplicati.
Oltre alle ovvie duplicazioni, troverete lievi variazioni che in realtà rappresentano gli stessi dati : nomi con lettere maiuscole e minuscole miste, spazi aggiuntivi, abbreviazioni diverse o date con formati differenti che il sistema non riconosce come uguali, anche se per una persona è ovvio che si riferiscono alla stessa cosa.
L'impatto è significativo: le statistiche vengono distorte, il numero di clienti o pazienti viene gonfiato , gli indirizzi email vengono ripetuti nelle campagne di email marketing, le fatture vengono duplicate o il numero di ordini viene sovrastimato. Ciò può portare a decisioni errate, costi aggiuntivi e una profonda mancanza di fiducia nella qualità dei dati.
Pertanto, prima di addentrarsi in dashboard o analisi avanzate, è consigliabile dedicare del tempo a una pulizia accurata dei dati per individuare e correggere le incongruenze . La rimozione dei duplicati è una parte fondamentale di questo processo, ma non l'unica: è necessario anche standardizzare il testo , eliminare gli spazi superflui e normalizzare le date.
Rileva ed evidenzia i dati duplicati nei fogli di calcolo
Strumenti come Excel offrono comode funzioni per identificare rapidamente i valori ripetuti all'interno di un intervallo di celle . Prima di eliminare qualsiasi elemento, è consigliabile utilizzare un formato visivo che vi aiuti a rivedere e decidere con calma cosa conservare.
Un metodo comune per iniziare è utilizzare la formattazione condizionale per evidenziare i valori che compaiono più di una volta . In questo modo, non si modifica il contenuto delle celle, ma le si contrassegna semplicemente per l'analisi.
Il flusso di lavoro tipico prevede innanzitutto la selezione delle celle da esaminare e quindi l'applicazione di una regola di formattazione condizionale che contrassegna i duplicati con un colore di sfondo o un carattere diverso . Questo permette di identificare schemi ricorrenti: ad esempio, per verificare se una persona compare più volte in un elenco clienti o se determinati codici prodotto sono stati registrati più di una volta.
Inoltre, è possibile combinare questa evidenziazione automatica con i filtri all'interno del foglio di calcolo stesso per visualizzare solo le righe interessate dai duplicati e rivederle una per una . Ciò offre un maggiore controllo e riduce il rischio di eliminare accidentalmente informazioni importanti.
Rimuovere in modo sicuro i valori duplicati in Excel
Una volta identificati i duplicati, Excel include una funzione specifica chiamata "Rimuovi duplicati" che elimina definitivamente le righe ripetute . È qui che bisogna fare molta attenzione, perché ciò che si elimina non è facilmente recuperabile se non si è salvata una copia.
Prima di eseguire questo strumento, si consiglia vivamente di copiare l'intervallo di dati originale in un altro foglio o file di backup . In questo modo, se la pulizia produce un risultato imprevisto, è possibile esaminare i dati rimossi e recuperare le informazioni senza problemi.
La procedura prevede la selezione dell'intervallo di celle da pulire e la successiva specificazione delle colonne in cui confrontare i valori per determinare se una riga è un duplicato. Se si selezionano più colonne, verrà considerata duplicata solo la riga la cui combinazione completa corrisponde a un'altra riga , il che risulta molto utile quando si lavora con dati complessi.
Dopo aver confermato l'operazione, Excel rimuove le righe in eccesso e visualizza un riepilogo che mostra quanti duplicati sono stati eliminati e quanti record univoci sono rimasti . Questo breve report consente di verificare se i risultati corrispondono alle aspettative iniziali.
È importante tenere presente che filtrare per valori univoci non è la stessa cosa di rimuovere i duplicati . Quando si applica un filtro, le righe ripetute vengono semplicemente nascoste temporaneamente, ma rimangono comunque presenti; quando si rimuovono i duplicati, questi vengono eliminati definitivamente. Pertanto, partire da un filtro univoco o dalla formattazione condizionale è una strategia più prudente.
Criteri per considerare un valore da duplicare
Quando gli strumenti per fogli di calcolo confrontano i duplicati, lo fanno in base a ciò che viene effettivamente visualizzato nella cella, non al valore interpretato sottostante . Questo ha alcune conseguenze interessanti di cui è necessario essere consapevoli per evitare sorprese.
Ad esempio, due date che rappresentano lo stesso giorno potrebbero non essere considerate duplicate se una è scritta come "08/03/2006" e l'altra come "8 marzo 2006" , poiché il contenuto del testo è diverso anche se il significato è identico. Lo stesso può accadere con nomi e stringhe con spazi o maiuscole diverse.
Allo stesso modo, un numero memorizzato come testo e lo stesso numero in formato numerico possono essere trattati come valori diversi. Ecco perché è così importante normalizzare i formati prima di tentare di eliminare in blocco le righe duplicate.
Prima di procedere a una pulizia aggressiva, è consigliabile filtrare i valori univoci o utilizzare la formattazione condizionale per verificare che i criteri di confronto funzionino come previsto . Regolare queste regole fin dall'inizio evita di perdere dati validi o di lasciare duplicati nascosti.
Funzioni di testo nei fogli di calcolo per pulire i dati sporchi
Gran parte del problema dei duplicati non deriva dalla ripetizione dello stesso valore, bensì dalla scrittura degli stessi dati in modi leggermente diversi . È qui che entrano in gioco le funzioni di testo di Excel o Fogli Google, per standardizzare e preparare i dati prima di rimuovere i duplicati.
È molto comune trovare colonne in cui alcuni nomi sono in maiuscolo, altri in minuscolo e altri ancora sono mescolati in modo casuale. Per standardizzare questa situazione, esistono funzioni che convertono tutto in minuscolo, tutto in maiuscolo o mettono in maiuscolo solo la prima lettera di ogni parola . Questo garantisce che "ANA PÉREZ", "ana pérez" e "Ana Pérez" vengano trattati tutti allo stesso modo.
Sono frequenti anche i testi con spazi aggiuntivi, sia all'interno della stringa che all'inizio o alla fine . Una funzione specifica può rimuovere questi spazi extra, lasciando solo uno spazio normale tra le parole, eliminando così frasi come "Juan García" o simili che interrompono i confronti.
Per i dati ravvicinati, come codici combinati o nomi e cognomi nella stessa cella, è utile utilizzare le funzioni di estrazione e unione. È possibile estrarre una porzione di testo specificando la posizione iniziale e il numero di caratteri, oppure combinare più stringhe in una sola per creare campi più coerenti.
Nel caso delle date, se arrivano come testo con stili diversi, è consigliabile convertirle in un formato data standard basato su anno, mese e giorno . In questo modo, i fogli di calcolo le tratteranno come date reali, sarà possibile ordinarle correttamente e i confronti non dipenderanno più dall'aspetto della cella.
Filtra i valori univoci e rimuovi i duplicati nei fogli di calcolo
Oltre agli strumenti di formattazione e alle funzioni di testo, sia Excel che Fogli Google consentono di filtrare rapidamente i dati per visualizzare solo i valori univoci in una colonna o in un insieme di colonne . Questo è un metodo molto efficace per esaminare i risultati prima di prendere decisioni definitive.
In alcuni ambienti, è possibile utilizzare opzioni di filtro avanzate per specificare che si desidera visualizzare solo le righe con valori univoci in una o più colonne specifiche. Questo filtro non elimina i dati; si limita a nascondere temporaneamente i duplicati , rappresentando quindi un passaggio intermedio molto prudente.
Una volta confermato che la vista univoca è quella desiderata, è possibile rimuovere i duplicati direttamente dai menu dei dati tramite comandi specifici . In genere, si accede a una sezione come "Dati > Rimuovi duplicati", dove si scelgono le colonne su cui basare il confronto.
Un'altra opzione è quella di utilizzare la formattazione condizionale per evidenziare sia i valori duplicati che quelli univoci, a seconda delle esigenze. Ad esempio, è possibile evidenziare con un colore acceso le righe che compaiono una sola volta e analizzare se si tratta di valori anomali, errori di caricamento o semplicemente casi rari che devono essere conservati.
Se lavori con elenchi a discesa o con la convalida dei dati, è molto utile anche ripulirli. Tramite i menu di convalida, puoi definire elenchi chiusi che impediscono le variazioni tipografiche , eliminando di fatto la comparsa di falsi duplicati che in realtà sono semplici errori di battitura.
Pulizia dei duplicati nei database SQL con SELECT DISTINCT
Quando si passa dal mondo dei fogli di calcolo a quello dei database , l'approccio cambia leggermente. In SQL, uno dei primi strumenti per gestire le informazioni duplicate è l' operatore DISTINCT, che viene utilizzato insieme al comando SELECT per restituire righe senza duplicati nei risultati di una query.
L'idea è semplice: quando si costruisce un'istruzione SELECT, è possibile aggiungere la parola chiave DISTINCT per indicare che si desidera una sola occorrenza di ogni combinazione di valori nelle colonne selezionate. In questo modo, se la stessa riga logica si ripete più volte nella tabella, la query restituirà una sola riga.
È importante capire che SELECT DISTINCT non elimina nulla dal database; influisce solo sul risultato visualizzato durante l'esecuzione della query . Le informazioni originali rimangono invariate nelle tabelle, il che è perfetto per le analisi esplorative in cui non si desidera modificare i dati in questa fase.
In termini di sintassi, lo schema generale prevede la combinazione di SELECT DISTINCT con l'elenco delle colonne di interesse, seguita dalla clausola FROM per specificare la tabella e, facoltativamente, da una clausola WHERE per filtrare in base a condizioni specifiche . Questo permette di richiedere, ad esempio, solo clienti unici provenienti da un determinato paese o prodotti unici appartenenti a una particolare categoria.
Questo approccio è molto utile quando si desidera ridurre i risultati alle sole voci non ripetute, sia per ottenere un elenco di clienti senza duplicazioni dovute a ordini multipli , sia per visualizzare un elenco di codici prodotto distinti, sia per generare un conteggio degli elementi unici in un dataset.
Differenze tra DISTINCT e altri modi per evitare duplicati in SQL
Sebbene DISTINCT e UNIQUE possano sembrare simili, non svolgono lo stesso ruolo nell'ecosistema SQL . DISTINCT opera nelle query SELECT, influenzando le righe restituite; UNIQUE è solitamente correlato ai vincoli nelle definizioni delle tabelle, indicando che determinati campi non possono contenere valori ripetuti.
Inoltre, in contesti con grandi quantità di dati, l'utilizzo di SELECT DISTINCT può risultare oneroso in termini di prestazioni, poiché il motore del database deve confrontare tutte le colonne selezionate per determinare quali righe sono uguali. In tabelle di grandi dimensioni o con molte colonne, questo può diventare un processo che richiede molte risorse.
Pertanto, in alcuni casi vale la pena considerare delle alternative. Una delle più comuni è quella di utilizzare GROUP BY per raggruppare le righe in base a una o più colonne e applicare funzioni di aggregazione (come COUNT, MIN o MAX) che consentono di riepilogare i dati in modo efficiente.
È inoltre possibile utilizzare clausole come EXISTS per verificare se determinati valori sono presenti in un'altra tabella , evitando righe duplicate non necessarie. In alternativa, è possibile utilizzare subquery con clausole SELECT, FROM e WHERE ben definite per specificare meglio i record da recuperare.
Quando si desidera contare quanti valori univoci sono presenti in una colonna, è comune combinare COUNT con DISTINCT, in modo da ottenere direttamente il numero di elementi diversi senza doverli controllare manualmente uno per uno.
Esempi pratici: richieste dei clienti e indirizzi senza duplicati
Immagina di lavorare con una tabella degli ordini in cui ogni riga rappresenta un acquisto. È frequente che lo stesso cliente compaia più volte se ha effettuato più di un ordine . Se desideri visualizzare ogni cliente una sola volta, la clausola SELECT DISTINCT è uno strumento molto efficace.
In questo scenario, si creerebbe una query che seleziona le colonne di identificazione del cliente (ad esempio, ID e nome) e si applicherebbe la clausola DISTINCT per ottenere un elenco in cui ogni cliente compare una sola volta , anche se la tabella originale contiene dieci ordini distinti.
Qualcosa di simile accade se devi visualizzare tutti gli indirizzi di spedizione univoci a cui sono stati inviati i prodotti . Se ogni ordine include un indirizzo, la tabella sarà piena di duplicati; tuttavia, utilizzando DISTINCT nelle colonne degli indirizzi, puoi generare un elenco compatto di punti di spedizione.
Quando si desidera concentrarsi sui clienti di una regione specifica, è possibile aggiungere una clausola WHERE per indicare, ad esempio, che si è interessati solo ai record provenienti da un determinato paese . In questo modo, SELECT DISTINCT agisce su un sottoinsieme della tabella e non su tutti i dati.
In ambito sanitario o accademico, l'operatore risulta inoltre molto pratico per raggruppare i dati di pazienti o autori che compaiono più volte in studi o articoli diversi, visualizzando una singola voce per ciascuna entità a fini di analisi.
Gestione dei riferimenti duplicati nei database bibliografici
Nell'ambito della documentazione scientifica, i database bibliografici offrono spesso strumenti specifici per eliminare i riferimenti duplicati durante la ricerca tra fonti diverse. Questo è fondamentale per evitare che le vostre revisioni della letteratura si riempiano di articoli duplicati.
In questi sistemi, di solito è presente un comando "Rimuovi duplicati" nel menu Strumenti, che analizza il set di risultati ed elimina automaticamente i riferimenti ripetuti . Il sistema in genere segnala quanti elementi sono stati rimossi e quanti ne rimangono nel set corrente.
Molte piattaforme consentono di configurare, in una sezione delle preferenze, la rimozione automatica dei riferimenti duplicati ogni volta che si effettua una nuova ricerca. Ciò consente di risparmiare molto lavoro manuale, sebbene sia consigliabile verificare regolarmente che i criteri di esclusione dei duplicati siano appropriati.
Oltre alla cancellazione in blocco, questi gestori consentono di selezionare manualmente riferimenti specifici per decidere se conservarli o eliminarli. Questa revisione manuale è utile quando il sistema non è certo che due record si riferiscano allo stesso articolo o a versioni diverse (ad esempio, preprint e versioni finali).
Dopo aver rimosso i duplicati, il set di risultati viene aggiornato e visualizza il numero ridotto di riferimenti . Questo controllo numerico aiuta a verificare l'efficacia della pulizia e consente di documentare il processo nelle revisioni sistematiche o nei report di ricerca.


Scrittore appassionato del mondo dei byte e della tecnologia in generale. Adoro condividere le mie conoscenze attraverso la scrittura, ed è quello che farò in questo blog, mostrarti tutte le cose più interessanti su gadget, software, hardware, tendenze tecnologiche e altro ancora. Il mio obiettivo è aiutarti a navigare nel mondo digitale in modo semplice e divertente.