- Un incident de cybersécurité nécessite un plan préalable, un inventaire des actifs et une gouvernance claire pour coordonner la réponse.
- La détection précoce, le confinement rapide et le rétablissement ordonné minimisent l'impact technique et commercial.
- Une communication transparente, la conformité réglementaire et une assurance contre les cyber-risques sont des éléments essentiels en cas d'incidents graves.
- L’analyse post-incident et l’audit continu transforment chaque attaque en une opportunité de renforcer la cyber-résilience.
Aujourd'hui, aucune entreprise n'est à l'abri d'un incident de cybersécurité : rançongiciels, fuites de données, hameçonnage ciblé, accès non autorisé… La question n'est plus de savoir si vous subirez une attaque, mais quand et comment vous y préparer. Disposer d'une liste de contrôle claire des actions à entreprendre après un incident fait toute la différence entre une alerte maîtrisée et une crise opérationnelle, financière et de réputation majeure.
Cet article compile et réorganise les bonnes pratiques issues des guides du NIST, de l'INCIBE, du CIS et de fournisseurs spécialisés en réponse aux incidents. Vous y découvrirez chaque étape : comment identifier un incident, les actions à entreprendre minute par minute pour le contenir, comment restaurer les systèmes de manière fiable et quels points analyser ensuite pour en ressortir plus forts. L'objectif est de vous fournir un guide pratique, que vous soyez responsable technique ou gestionnaire.
Qu’est-ce qu’un incident de cybersécurité et quand faut-il activer la liste de contrôle ?
Un incident de cybersécurité désigne tout événement compromettant la confidentialité, l'intégrité ou la disponibilité des informations ou des systèmes d'une organisation. Il peut être causé par des attaques malveillantes, des défaillances internes, des erreurs humaines ou des problèmes avec des fournisseurs externes, mais le résultat est le même : vos opérations sont menacées.
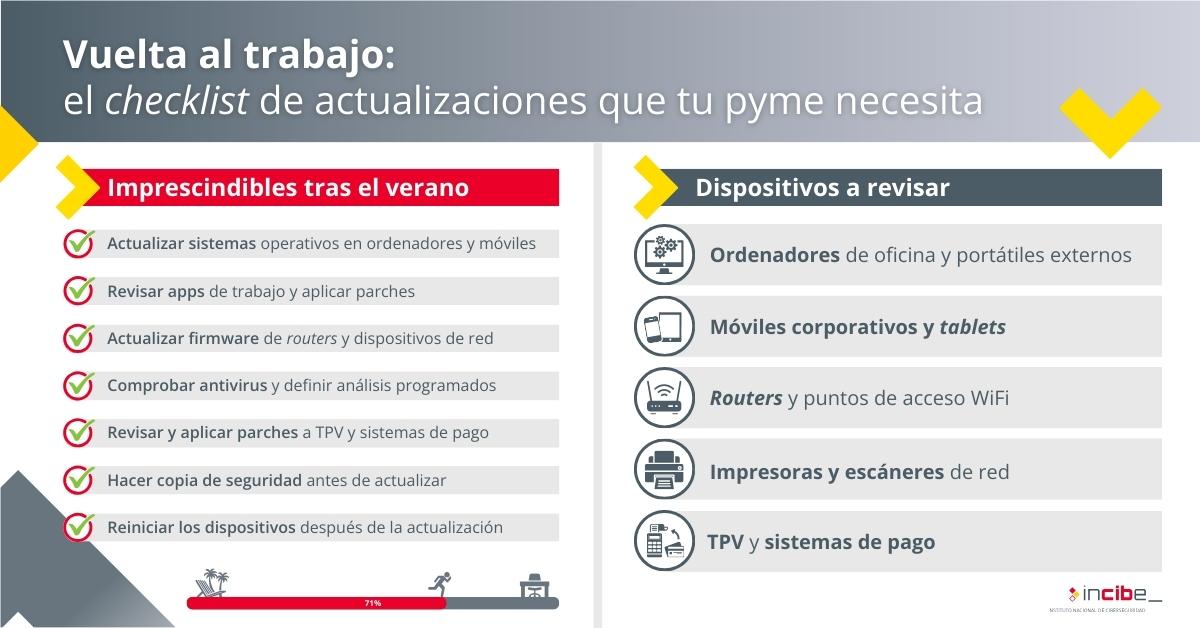
En pratique, vous devez activer votre plan de gestion des incidents lorsqu'au moins un de ces paramètres est rempli : des informations sensibles ont été consultées sans autorisation, des données ou des systèmes ont été modifiés sans contrôle, des services critiques sont hors service, une perte ou un vol de données est détecté, ou des comportements anormaux sont observés qui ne correspondent pas aux opérations normales.
Parmi les exemples courants d'incidents, citons le vol d'identifiants ou d'identité numérique , les campagnes d'hameçonnage qui parviennent à tromper le personnel clé, les infections par des logiciels malveillants (en particulier les ransomwares et les logiciels espions), les attaques par déni de service distribué (DDoS), l'exploitation de vulnérabilités non corrigées, les intrusions dans le réseau de l'entreprise, les fuites de données par des employés mécontents ou la perte d'appareils portables contenant des données sensibles.
Dans les environnements industriels (ICS/OT), les incidents peuvent dépasser le cadre de l'informatique traditionnelle et affecter les systèmes de contrôle, les automates programmables, les systèmes SCADA ou les unités terminales distantes (RTU) , impactant directement la production, la sécurité physique et l'environnement. Par conséquent, dans ces cas, la détection précoce et la cyber-résilience ne sont pas un luxe, mais une nécessité.
Le contexte n'arrange rien : des rapports comme ceux du FBI et d'INCIBE font état de pertes se chiffrant en millions et de dizaines de milliers d'incidents chaque année , touchant notamment les PME, les micro-entreprises et les travailleurs indépendants. Dans ce contexte, votre liste de contrôle des actions n'est plus un simple document qui prend la poussière dans un tiroir, mais un outil opérationnel qui doit être constamment mis à jour, revu et testé.
Cadre général de la liste de contrôle : de l’identification à la récupération
Les meilleures recommandations internationales s'accordent à dire qu'une réponse efficace aux incidents s'articule autour de plusieurs fonctions ou phases. Le référentiel classique du NIST les regroupe en cinq domaines principaux : identification, protection, détection, réponse et rétablissement. D'autres référentiels, comme ceux de Check Point ou du CIS, les décomposent en six : préparation, identification/évaluation, confinement, réponse, rétablissement et analyse.
Pour disposer d'une liste de contrôle vraiment utile après un incident, il est préférable de combiner les deux perspectives : les actions menées avant l'attaque (préparation et protection) , celles menées pendant (détection, évaluation, confinement et intervention) et celles menées après (reprise, analyse et amélioration continue). Négliger l'une de ces étapes est généralement coûteux.
Outre le cycle NIST, les secteurs critiques évoquent la cyber-résilience : la capacité d’anticiper les attaques, d’y résister, de s’en remettre et d’évoluer face à elles. Cela implique de mesurer, à l’aide d’indicateurs spécifiques (IMC), la capacité à anticiper, à maintenir les fonctions critiques pendant une attaque, à les rétablir rapidement, puis à tirer des enseignements et à s’améliorer.
Enfin, cette liste de contrôle n'est pas un outil isolé : elle s'appuie sur un plan de gestion des incidents de cybersécurité et, en matière de continuité d'activité, sur des plans de reprise après sinistre (PRA) et des plans de continuité d'activité (PCA). En cas d'incident grave, tous ces dispositifs sont activés successivement.
Préparation préalable : inventaire, gouvernance et culture de sécurité
Pour gérer efficacement un incident, il est essentiel de bien se préparer au préalable. La première partie de la liste de contrôle consiste à identifier les ressources disponibles, les responsables et les procédures de sécurité en vigueur dans votre organisation.
Concrètement, vous avez besoin d'un inventaire complet et à jour de vos actifs : données, matériel, logiciels, systèmes critiques, services cloud, appareils mobiles, systèmes de contrôle industriel (ICS) le cas échéant… Une liste générique ne suffit pas ; vous devez identifier les propriétaires, l'emplacement et le niveau de criticité, et revoir cet inventaire périodiquement.
Cet inventaire sert à réaliser des évaluations de vulnérabilité et de menaces : analyses régulières, revues de configuration et analyses de risques évaluant la probabilité et l’impact. Les résultats doivent permettre de prioriser les correctifs et les mesures d’atténuation à appliquer en premier et être formellement documentés afin de justifier les décisions auprès de la direction ou des auditeurs.
Un autre aspect essentiel de la préparation concerne les relations avec les fournisseurs et les tiers . La liste de contrôle doit vous inciter à identifier les fournisseurs critiques, à examiner les clauses de sécurité des contrats et des SLA, à évaluer leur niveau de sécurité et à mettre à jour régulièrement cette évaluation. De nombreuses violations de données proviennent d'un fournisseur dont les contrôles sont insuffisants.
Au niveau gouvernemental, chaque entreprise, quelle que soit sa taille, devrait définir une stratégie de cybersécurité adaptée à son activité , attribuer des responsabilités clairement définies (même sans RSSI officiel) et réaliser des évaluations des risques régulières. Sur le plan humain, il est indispensable de disposer de politiques de sécurité internes documentées, de procédures d'intégration et de départ des employés transparentes, d'une gestion des accès et d'une culture où le signalement des activités suspectes n'est pas perçu comme une contrainte, mais comme une responsabilité partagée.
Niveaux de protection : accès, réseau, terminaux et sauvegardes
Le deuxième élément majeur concerne toutes les mesures prises pour limiter au maximum la survenue ou l'aggravation d'un incident . Cela inclut le contrôle d'accès, la protection du périmètre et du réseau, la sécurité des terminaux et des serveurs, et bien sûr, les sauvegardes.
Pour la gestion des identités et des accès, votre liste de contrôle devrait inclure l'authentification multifacteur avec FIDO2 pour la messagerie, le VPN et les applications critiques ; des politiques de mots de passe robustes et leur renouvellement régulier ; des revues d'autorisations au moins trimestrielles ; et la désactivation immédiate des comptes en cas de départ d'un utilisateur. Le tout doit respecter le principe du moindre privilège.
Au niveau du réseau, les exigences minimales raisonnables aujourd'hui comprennent un pare-feu de nouvelle génération bien configuré (avec IPS, filtrage web et antivirus réseau), une segmentation VLAN pour isoler les environnements et services critiques, des VPN sécurisés pour l'accès distant et un processus formel de révision des règles. Sans segmentation, un incident sur un poste de travail peut se propager à l'ensemble du réseau en quelques minutes.
Sur les terminaux et les serveurs, la liste de contrôle doit vérifier l'existence de solutions antivirus/antimalware centralisées et de solutions EDR ou XDR , d'un antispam pour les e-mails, de correctifs réguliers pour les systèmes et les applications, d'une gestion des appareils mobiles ( BYOD sécurisé dans l'entreprise ), d'un contrôle des privilèges locaux et, le cas échéant, d'un contrôle de l'utilisation des périphériques USB et autres périphériques amovibles.
La dernière ligne de défense est constituée par les sauvegardes . Celles-ci doivent être automatiques, fréquentes, externes au serveur principal, idéalement répliquées dans le cloud ou un environnement isolé, chiffrées avec gestion des clés et à accès restreint. Et un point souvent négligé : il est impératif de tester la procédure de restauration au moins une fois par mois. Une sauvegarde irrécupérable en cas d’incident est inutile.
Détection précoce : comment savoir si vous êtes confronté à un incident
Une fois la maison plus ou moins bien protégée, la section suivante de la liste de vérification consiste à détecter rapidement tout problème . Plus tôt vous le repérez, moins les dégâts seront importants.
Idéalement, vous devriez disposer d'une combinaison d' outils IDS/IPS, SIEM et de surveillance réseau et système qui collectent les journaux, corrèlent les événements et génèrent des alertes en cas de comportement anormal : pics de trafic, tentatives de connexion suspectes, exécution de fichiers binaires inhabituels, connexions à des domaines malveillants, etc.
La liste de contrôle devrait vous demander si vous avez des politiques de conservation et d'analyse des journaux , si celles-ci sont centralisées et revues régulièrement, si les alertes sont paramétrées pour éviter un grand nombre de faux positifs et si une personne est chargée de surveiller ce tableau de bord, que ce soit en interne ou par le biais d'un service de surveillance 24h/24 et 7j/7.
Dans les organisations plus matures, il peut être complété par des outils de détection proactive tels que des listes de domaines et d'adresses IP malveillantes, des honeypots, des sandboxes pour analyser les fichiers suspects, des WAF pour les applications Web, l'analyse NetFlow pour détecter les scans ou les attaques DDoS, et même la surveillance du trafic vers les adresses IP inutilisées (darknet) dans les grands réseaux.
Bien sûr, la technologie ne fait pas tout : la liste de contrôle devrait également inclure une formation de sensibilisation du personnel afin de l’inciter à signaler les courriels suspects, les messages d’extorsion, les comportements étranges sur ses appareils ou tout autre symptôme inhabituel. De nombreux incidents sont détectés en premier lieu par une personne qui se manifeste.
Activer l'équipe d'intervention en cas d'incident
Lorsqu'un incident grave se profile, la procédure doit clairement définir les rôles et les responsabilités de chacun . C'est là qu'intervient l'équipe de réponse aux incidents (IRT/CSIRT) ; il ne s'agit pas forcément d'un service important, mais plutôt d'un groupe de personnes identifiées par leurs fonctions.
Vous devriez au minimum désigner un responsable de la réponse aux incidents , des techniciens systèmes/réseaux/développement selon les besoins, une personne chargée des communications internes et externes, ainsi que des représentants juridiques et commerciaux pour les décisions critiques. Dans les petites entreprises, certains rôles peuvent se chevaucher, mais cela doit être anticipé.
Votre liste de contrôle d'activation doit inclure des questions très précises : qui signale le problème et par quel canal , qui valide qu'il s'agit d'un incident, qui est immédiatement informé (direction, fournisseur de sécurité, assureur en cyber-risques), quels canaux de communication seront utilisés pendant la crise (en évitant, si possible, les systèmes potentiellement compromis).
Il devrait également couvrir les relations avec les prestataires et autorités externes : dans quels cas un CSIRT externe ou les forces de sécurité sont contactés, quand l’assurance contre les cyber-risques entre en jeu, quelles données doivent être documentées dès le départ pour faciliter une éventuelle analyse forensique ou un soutien spécialisé.
Enfin, dans cette phase initiale, il est conseillé de faire un rapide bilan de l'incident : quels systèmes semblent affectés, quelles données peuvent être compromises, depuis quand, dans quel lieu ou siège social, s'il y a des indications de déplacement latéral ou d'exfiltration d'informations, et quel niveau de certitude nous avons à ce sujet.
Liste de contrôle pour le confinement et l'atténuation des attaques
Une fois l'incident confirmé, la priorité immédiate est de stopper l'hémorragie sans aggraver les dégâts . Votre liste de contrôle doit faire la distinction entre les actions de confinement à court terme et les mesures d'atténuation plus structurelles.
Parmi les premières mesures figurent généralement l' isolation des équipements et des segments de réseau affectés (déconnexion du réseau, segmentation des VLAN, blocage d'adresses IP ou de domaines spécifiques), le changement urgent des identifiants compromis, la révocation des jetons ou certificats suspects (voir) et la restriction temporaire de l'accès à distance ou des privilèges de certains comptes.
La liste de contrôle devrait vous demander de vérifier si des fuites de données supplémentaires sont évitées : blocage temporaire des clés USB, fermeture des dossiers partagés critiques, examen des règles DLP le cas échéant, surveillance du trafic sortant inhabituel, etc. Tout ce qui limite la surface de données sortantes sans rendre impossible la fonctionnalité minimale.
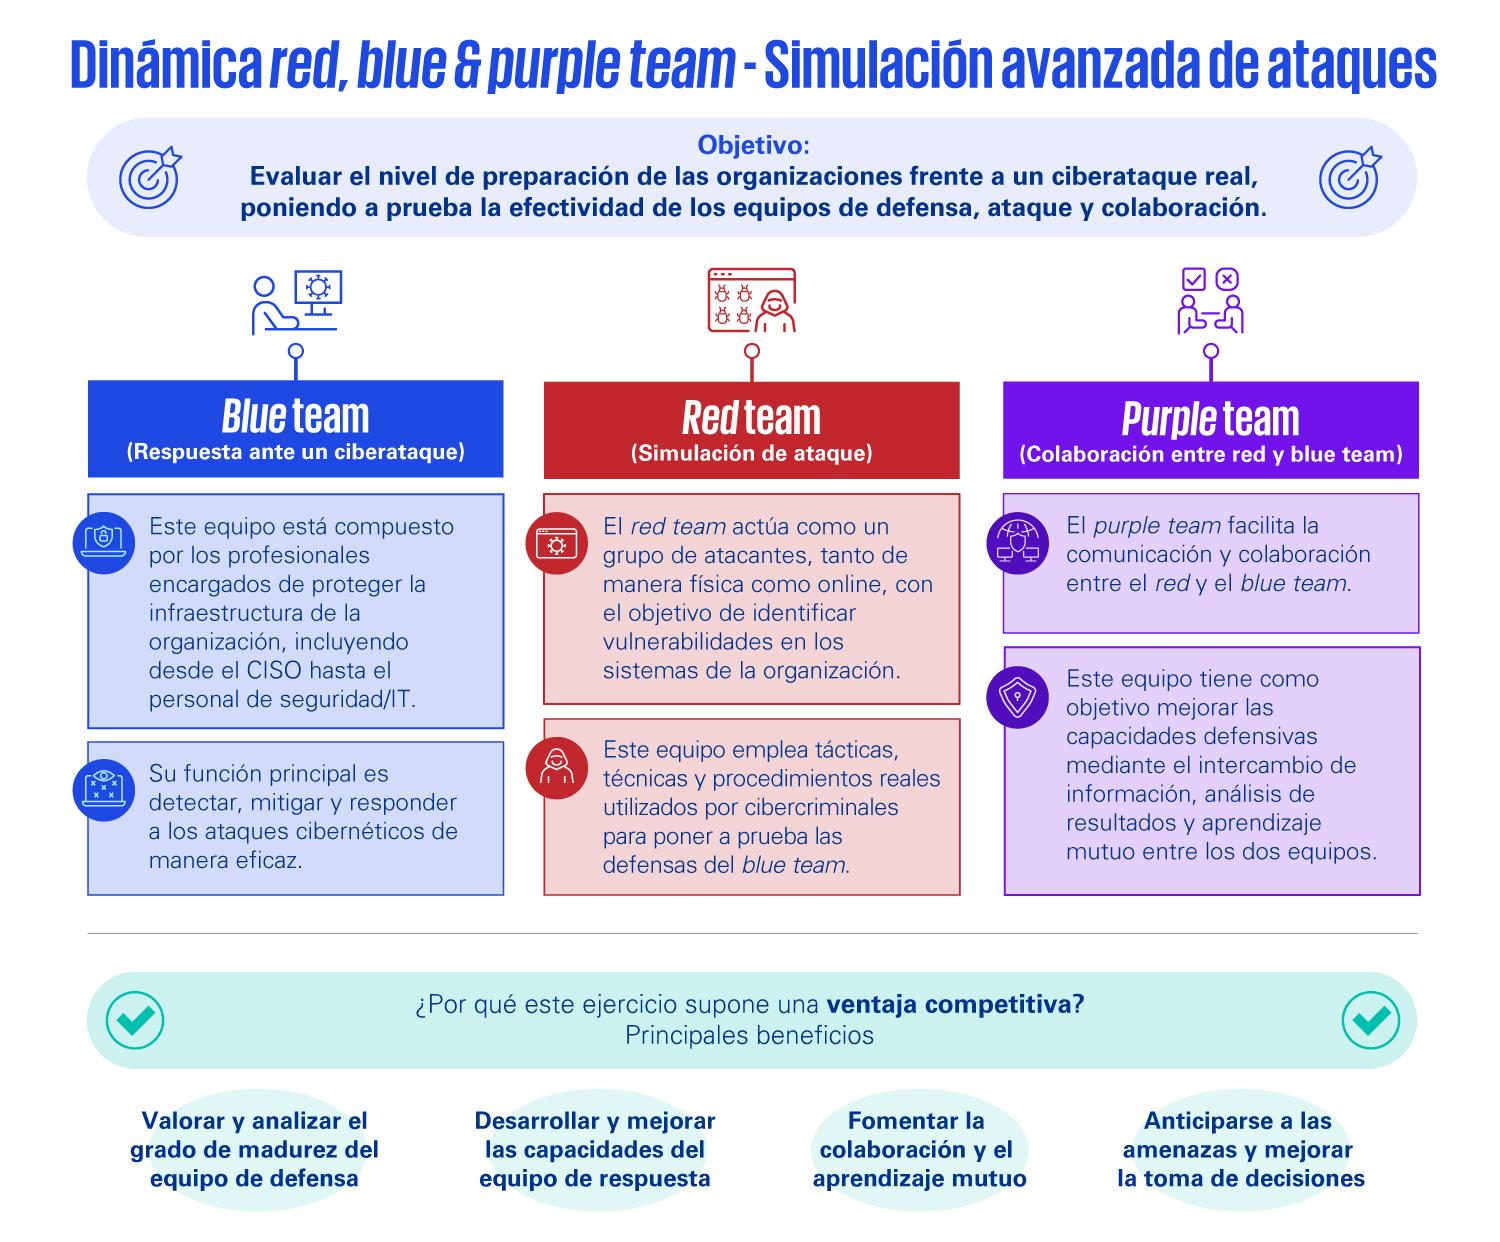
Parallèlement, l' analyse technique de l'incident débute : identification du logiciel malveillant (à l'aide d'un environnement isolé si nécessaire), examen des journaux pour établir une chronologie, identification du vecteur d'entrée (hameçonnage, vulnérabilité, identifiants volés, etc.), recherche d'indicateurs de compromission (IoC) sur d'autres systèmes, etc. Il est essentiel de conserver les preuves à ce stade en vue d'une éventuelle analyse forensique ou pour se conformer aux obligations légales.
À un niveau d'atténuation plus stratégique, la liste de contrôle devrait inclure l'application de correctifs ou de modifications de configuration qui comblent la faille exploitée par l'attaquant, le renforcement temporaire des règles dans les pare-feu et les systèmes de détection, et la révision des politiques qui ont pu faciliter l'attaque (autorisations excessives, absence d'authentification multifacteur, etc.).
Assistance technique et récupération des systèmes et des données
Une fois la situation raisonnablement maîtrisée, il est temps d'éliminer la menace et de rétablir le fonctionnement normal des opérations . Cette phase exige patience et rigueur : toute précipitation risque de créer des failles, tandis qu'une lenteur excessive prolongera les répercussions sur l'activité.
Lors de l'éradication, la liste de contrôle doit vous guider pour supprimer les logiciels malveillants, les comptes malveillants, les configurations compromises et les accès résiduels . Cela peut impliquer la réinstallation des systèmes, le changement massif des mots de passe, la révocation des clés et des certificats, le nettoyage du registre, la vérification de la gestion des clés de démarrage sécurisé , la mise à jour du micrologiciel, voire le remplacement du matériel en cas de signes de manipulation importante.
La reprise d'activité repose sur les plans de reprise après sinistre (PRA) : restauration des systèmes à partir de sauvegardes fiables , priorisation des services critiques et vérification de l'intégrité et du bon fonctionnement de chaque sauvegarde avant leur diffusion aux autres utilisateurs. En cas d'incident tel qu'une attaque par rançongiciel, il est crucial de s'assurer qu'aucune sauvegarde déjà infectée n'est restaurée.
Durant cette phase, la liste de contrôle doit nous rappeler la nécessité de communiquer en interne l'état de la reprise (pour éviter les rumeurs et les décisions improvisées), de nous coordonner avec les fournisseurs d'infrastructure (cloud, communications, etc.) et de tenir un registre détaillé de toutes les actions entreprises et des délais de reprise des services.
C’est également le moment d’activer, le cas échéant, votre assurance cyber-risques : prise en charge des frais de restauration des données et des systèmes, services d’intervention en cas d’incident, assistance juridique, notification des parties concernées, gestion de la réputation, perte de profits, voire, pour certaines polices, prise en charge des frais d’extorsion. Chaque police étant unique, il est conseillé de l’examiner attentivement avant tout incident.
Communication, notifications et aspects juridiques
Outre les aspects techniques, la liste de contrôle doit couvrir la gestion des communications et les obligations légales , notamment lorsque des données personnelles ou des services essentiels sont en jeu.
D'un point de vue réglementaire, il sera nécessaire d'évaluer, avec l'équipe juridique, s'il existe une obligation de notifier la violation aux autorités de protection des données (RGPD et réglementations locales), aux superviseurs sectoriels (par exemple, dans les secteurs critiques relevant de la NIS2) et, bien sûr, aux parties concernées elles-mêmes (clients, employés, partenaires), dans des délais précis et avec des exigences de contenu bien définies.
La liste de contrôle devrait inclure la préparation de communications claires, honnêtes et transparentes expliquant ce qui s'est passé, quelles données ont pu être affectées, quelles mesures sont prises et quelles recommandations sont formulées à l'intention des personnes concernées. Dissimuler ou minimiser un incident ne fait généralement qu'aggraver le problème à moyen terme.
Il est également conseillé de préparer d'éventuelles déclarations publiques ou une FAQ pour le site web de l'entreprise, les réseaux sociaux et autres médias, en fonction de l'ampleur de l'incident. En interne, il est essentiel de tenir les employés et les équipes informés afin qu'ils sachent comment réagir et ce qu'ils peuvent et ne peuvent pas dire à autrui.
Enfin, d’un point de vue juridique, la liste de contrôle devrait nous rappeler l’importance de conserver les preuves et la documentation en cas de réclamations, de sanctions, voire de poursuites pénales : journaux d’activité, rapports techniques, communications internes pertinentes et tout document fourni par les fournisseurs ou les assureurs.
Leçons tirées, audit continu et cyber-résilience
Une fois la phase la plus critique terminée, le travail ne s'arrête pas là. Une étape cruciale est souvent négligée : analyser en profondeur les événements et les traduire en améliorations concrètes , tant techniques qu'organisationnelles.
La première étape consiste à mener une analyse post-incident, ou une débriefing , avec la participation de tous les services concernés. Il s'agit de reconstituer la chronologie des événements, d'identifier les causes profondes (techniques, procédurales et culturelles), d'évaluer l'impact réel (économique, opérationnel et réputationnel) et d'examiner les points forts et les points faibles du plan d'intervention.
Cette analyse devrait se traduire par un plan d'action priorisé : renforcement des contrôles d'accès, modifications des configurations réseau, durcissement des politiques, formation accrue sur le phishing, intégration de nouveaux outils (par exemple, SIEM ou EDR s'ils n'étaient pas déjà utilisés), amélioration des sauvegardes, révision des contrats avec les fournisseurs, mise à jour du plan de réponse aux incidents lui-même, etc.
Dans le même temps, la liste de contrôle doit encourager l'audit et le contrôle continus (voir les conseils clés pour la création d'un rapport d'audit de sécurité ) : évaluations périodiques des risques, audits des systèmes et des politiques, exercices de simulation d'incidents, exercices de détection des menaces, examens des comptes et autorisations privilégiés, et préparation de rapports à l'intention de la direction comportant des risques et des propositions d'amélioration.
Tout cela contribue à bâtir une véritable cyber-résilience organisationnelle : la capacité d’anticiper (en améliorant les pratiques et les contrôles), de résister (en maintenant les services critiques pendant une attaque), de se rétablir rapidement (grâce à des plans de continuité d’activité robustes) et d’évoluer (en tirant les leçons de chaque incident). Il ne s’agit pas de ne jamais tomber, mais de se relever plus fort à chaque fois.
Disposer d'une liste de contrôle solide des actions à entreprendre après un incident de cybersécurité, bien liée à votre stratégie, vos processus et vos fournisseurs, vous permet de passer d'une réaction désespérée à une réponse intelligente : vous identifiez le problème plus tôt, le maîtrisez avec moins de dommages collatéraux, rétablissez votre activité de manière plus sûre et sortez de l'incident avec une posture de sécurité plus forte qu'auparavant, réduisant ainsi véritablement le risque qu'une prochaine attaque se termine en catastrophe.

Écrivain passionné par le monde des octets et de la technologie en général. J'aime partager mes connaissances à travers l'écriture, et c'est ce que je vais faire dans ce blog, vous montrer toutes les choses les plus intéressantes sur les gadgets, les logiciels, le matériel, les tendances technologiques et plus encore. Mon objectif est de vous aider à naviguer dans le monde numérique de manière simple et divertissante.