- Mikrodienste ermöglichen die Entwicklung modularer und skalierbarer Anwendungen, bei denen jeder Dienst autonom und unabhängig einsetzbar ist.
- Docker macht es einfach, leichtgewichtige, portable Container zu erstellen, die jeden Microservice mit all seinen Abhängigkeiten verpacken.
- Kubernetes orchestriert die Container und verwaltet die Bereitstellung, Skalierung, Vernetzung und automatische Wiederherstellung von Microservices im Cluster.
- Die Anwendung bewährter Sicherheits-, Überwachungs- und Automatisierungspraktiken ist der Schlüssel zum erfolgreichen Betrieb von Microservices in der Produktion.
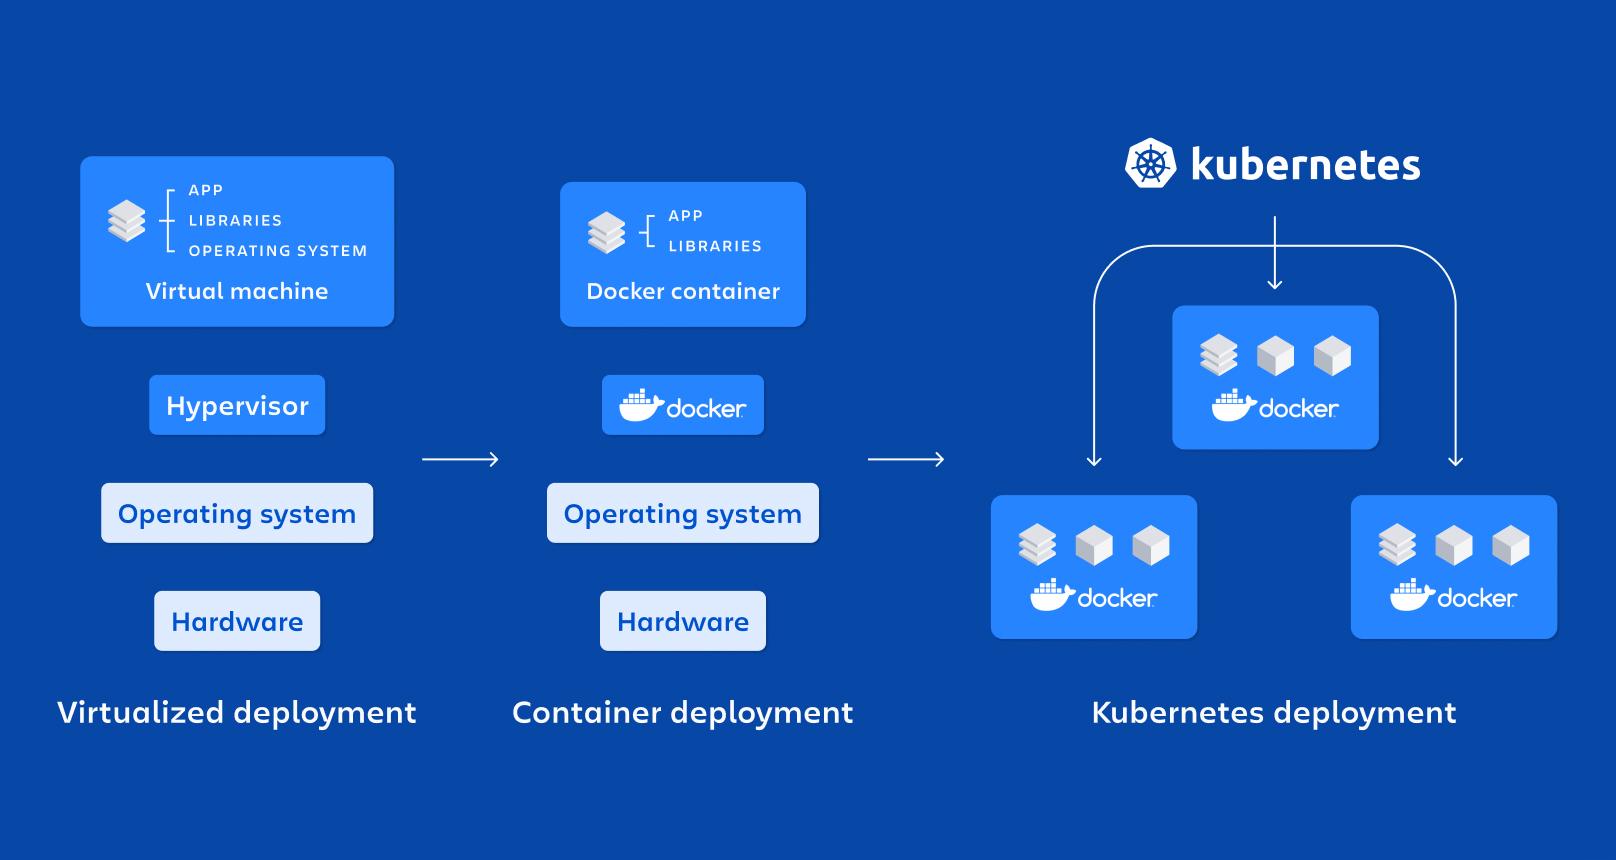
In den letzten Jahren hat sich die Kombination aus Microservices, Docker und Kubernetes zum De-facto-Standard für die Bereitstellung moderner, skalierbarer und wartungsfreundlicher Anwendungen entwickelt. Immer mehr Unternehmen verabschieden sich von monolithischen Anwendungen und setzen stattdessen auf verteilte Architekturen, die besser für sich verändernde Umgebungen und DevOps-Strategien geeignet sind.
Wenn Sie sich fragen, wie man Microservices mit Docker und Kubernetes in der Praxis implementiert , ist dieser Inhalt genau das Richtige für Sie: Wir werden die wichtigsten Konzepte, Vorteile und Herausforderungen besprechen, wie man Container erstellt, wie man sie in einem Cluster orchestriert und welche Schritte zur Installation unter Windows und Linux erforderlich sind , sowie eine Reihe von Tipps für deren sinnvolle Verwendung in realen Umgebungen.
Was ist eine Microservices-Architektur und wie unterscheidet sie sich von einer monolithischen Architektur?
Eine Microservices-Architektur basiert auf der Aufteilung einer Anwendung in mehrere kleine, autonome und unabhängig einsetzbare Dienste , die jeweils auf eine bestimmte Funktionalität (Benutzer, Zahlungen, Katalog, Bestellungen usw.) fokussiert sind und hauptsächlich über schlanke APIs (HTTP/REST, gRPC, Messaging usw.) kommunizieren.
Bei einer monolithischen Anwendung hingegen sind die gesamte Geschäftslogik, die Präsentationsschicht und der Datenzugriff in einem einzigen Bereitstellungsblock zusammengefasst ; jede Änderung erfordert das erneute Kompilieren, Testen und Bereitstellen des gesamten Systems, was die Weiterentwicklung erschwert und das Risiko erhöht, Fehler in die Produktion einzuführen.
Bei Microservices hat jeder Dienst seinen eigenen Lebenszyklus: Er kann unabhängig entwickelt, getestet, bereitgestellt, skaliert und versioniert werden . Dies ermöglicht es mehreren Teams, parallel zu arbeiten, vereinfacht die Einführung neuer Technologien und erleichtert die Integration mit CI/CD-Prozessen.
Darüber hinaus führt diese Architektur das Konzept der komponentenunabhängigen Skalierbarkeit ein : Anstatt eine gesamte monolithische Anwendung zu skalieren, um eine höhere Last auf einem bestimmten Modul zu bewältigen, werden nur die Microservices skaliert, die dies wirklich benötigen, wodurch die Infrastrukturressourcen besser optimiert werden.
Reale Vorteile und Herausforderungen von Microservices
Der Umstieg auf Microservices ist nicht nur eine Modeerscheinung: Er bringt spürbare Vorteile in Bezug auf Skalierbarkeit, Ausfallsicherheit und Bereitstellungsgeschwindigkeit mit sich , führt aber auch zu einer höheren betrieblichen Komplexität, die bewältigt werden muss.
Zu den herausragendsten Vorteilen zählt die unabhängige Skalierbarkeit jedes einzelnen Dienstes : Wenn beispielsweise das Zahlungsmodul mehr Datenverkehr empfängt als das Verwaltungsmodul, können Sie einfach die Anzahl der Replikate des Zahlungs-Mikrodienstes erhöhen, ohne den Rest der Anwendung zu beeinträchtigen oder Ressourcen zu verschwenden.
Auch kontinuierliche Bereitstellung und häufige Releases bieten erhebliche Vorteile . Durch die Isolation der einzelnen Dienste können neue Versionen inkrementell veröffentlicht werden, ohne die gesamte Anwendung anhalten oder neu bereitstellen zu müssen. Dies reduziert Wartungsfenster und beschleunigt die Markteinführung.
Ein weiterer wichtiger Punkt ist Ausfallsicherheit und Fehlertoleranz : Bei korrekter Konzeption sollte der Ausfall eines einzelnen Microservices nicht das gesamte System lahmlegen. Mithilfe von Mechanismen wie Timeouts, Wiederholungsversuchen und Circuit Breakern können die anderen Services weiterhin reagieren, wodurch die Auswirkungen von Fehlern begrenzt werden.
Darüber hinaus ermöglichen Microservices technologische Flexibilität : Jedes Team kann die am besten geeignete Sprache, das am besten geeignete Framework oder die am besten geeignete Datenbank für seinen Dienst wählen, solange es die Kommunikationsverträge und die globalen Richtlinien der Plattform einhält.
Auf der anderen Seite steht die Komplexität des Betriebs und der Beobachtbarkeit . Die Verwaltung von Dutzenden oder Hunderten von Diensten erfordert den Umgang mit verteilten Netzwerken, dienstübergreifenden Traces, zentralisierter Protokollierung, Sicherheit, API-Versionierung und Datenkonsistenz, was fortschrittliche Tools und ausgereifte Prozesse voraussetzt.
Die Kommunikation zwischen Diensten wird ebenfalls komplexer : Es ist unerlässlich, den Datenaustausch, die Fehlerbehandlung, das Latenzmanagement und die Verhinderung von Systemausfällen durch langsame Abhängigkeiten sorgfältig zu planen. Testen und Debuggen sind nicht mehr trivial, da nicht mehr ein einzelner Block, sondern ein Satz miteinander verbundener Dienste getestet wird.
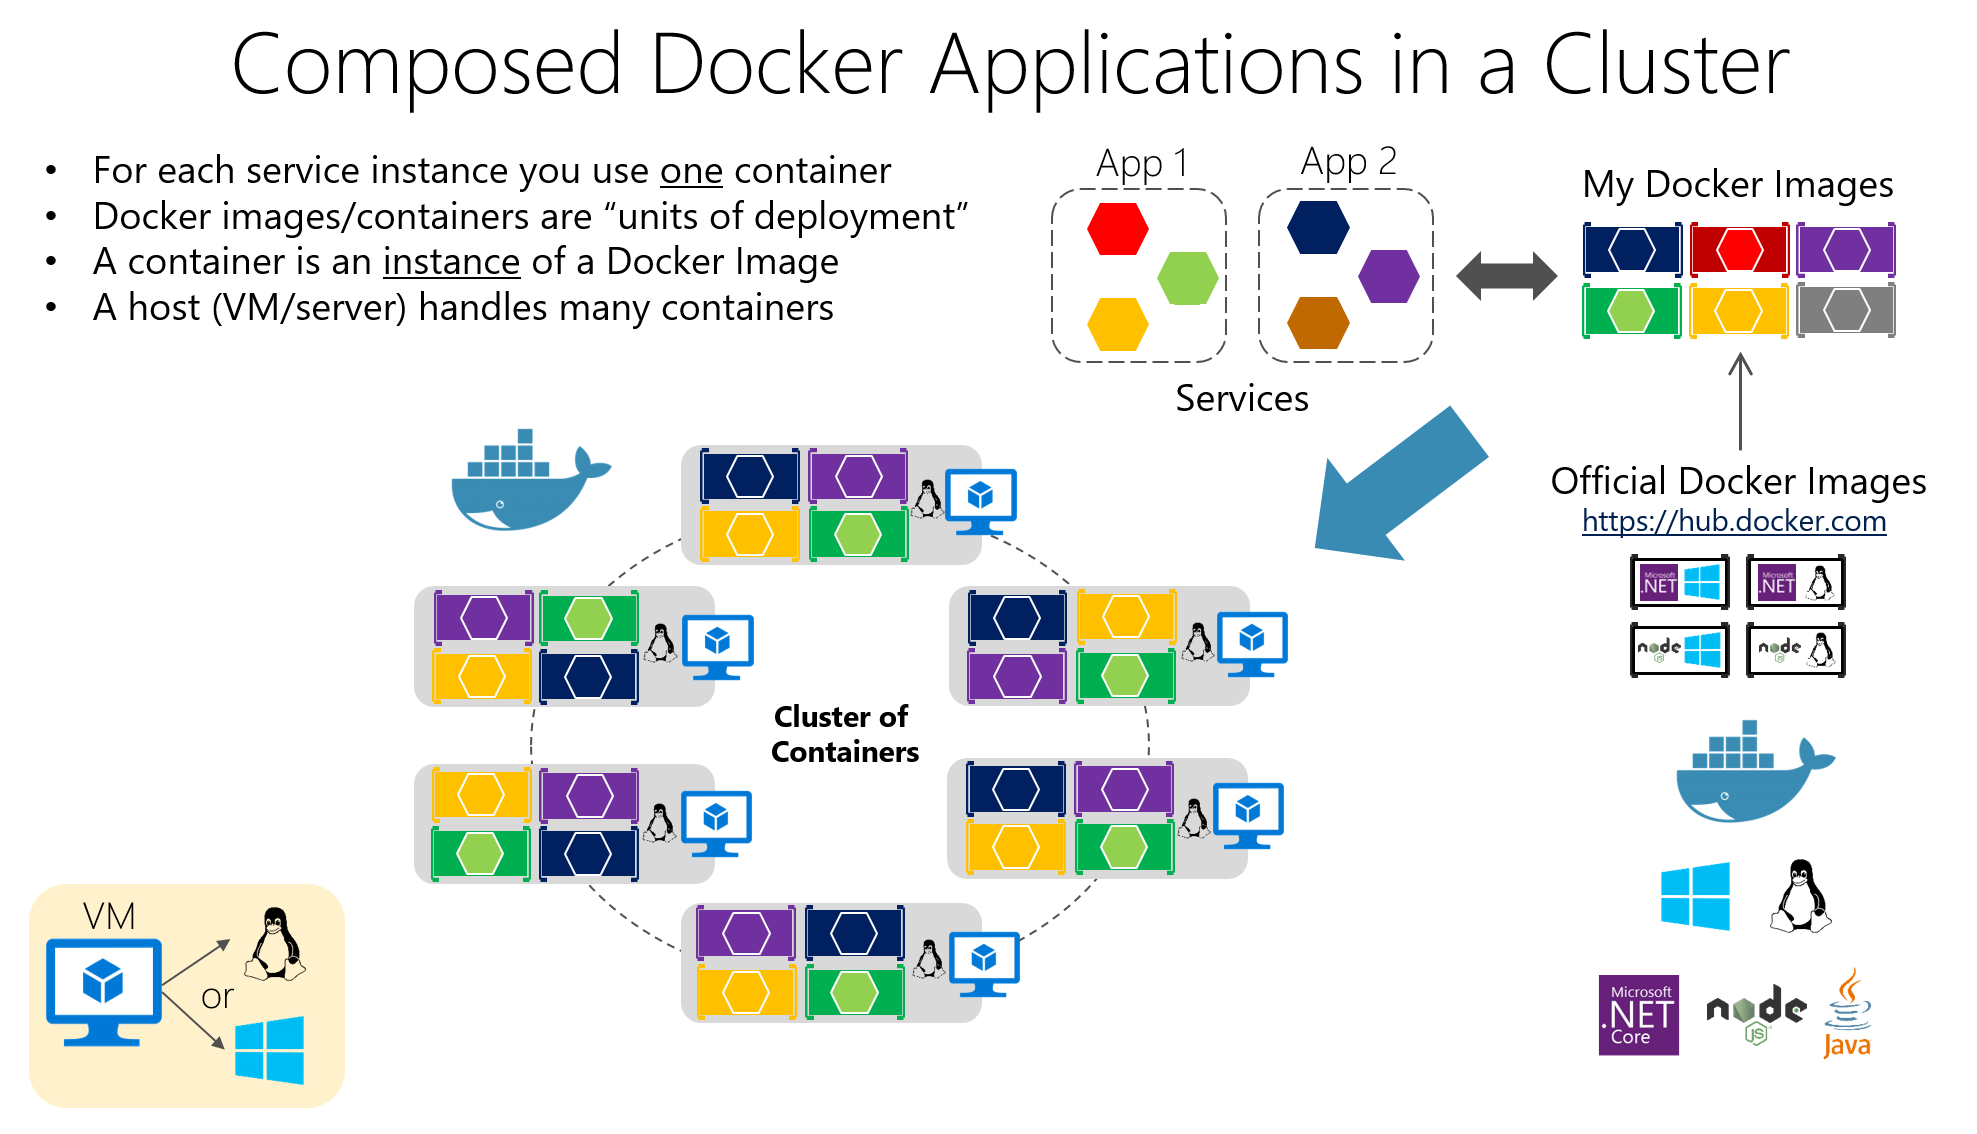
Container: Die Grundlage für den isolierten Betrieb von Microservices
Die Containertechnologie hat sich zur idealen Plattform für Microservices entwickelt, da sie es ermöglicht, eine Anwendung und alle ihre Abhängigkeiten in einer standardisierten, portablen Einheit zu verpacken . Anstatt Bibliotheken, Laufzeitumgebungen und Tools auf jedem Server zu installieren, läuft alles innerhalb des Containers.
Ein Container ist im Wesentlichen eine leichtgewichtige Form der Virtualisierung auf Betriebssystemebene : Er teilt sich den Host-Kernel, führt aber Prozesse in isolierten Namensräumen und mit durch Cgroups begrenzten Ressourcen aus, wodurch er schnell hochfährt und weniger Ressourcen verbraucht als eine virtuelle Maschine.
Zu ihren wichtigsten Eigenschaften zählen Isolation, Portabilität, geringe Größe und Modularität ; jeder in einem eigenen Container laufende Microservice lässt sich leichter bereitstellen, stoppen, aktualisieren oder replizieren und passt somit perfekt zu den Prinzipien verteilter Architekturen.
Im Vergleich zu virtuellen Produktionsmaschinen benötigen Container kein vollständiges Betriebssystem pro Instanz ; stattdessen nutzen sie das Betriebssystem des Hostsystems . Dies reduziert die Image-Größe und die Startzeit drastisch , sodass Container innerhalb von Sekunden gestartet oder beendet werden können.
Docker: Die Referenzplattform für die Containerisierung von Microservices
Docker ist das beliebteste Tool für die Arbeit mit Containern, da es die Erstellung, Verpackung, Verteilung und Ausführung containerisierter Anwendungen in Entwicklungs-, Test- und Produktionsumgebungen erleichtert.
Die Grundidee besteht darin, Software in Docker-Images zu verpacken . Diese unveränderlichen Artefakte enthalten den Anwendungscode, die benötigten Bibliotheken, Systemwerkzeuge und grundlegende Konfigurationen. Aus diesen Images werden lauffähige Container erstellt – isolierte Instanzen, die auf dem jeweiligen Image basieren.
Die Erstellung eines Images wird in einer Dockerfile definiert , einer Textdatei, die Anweisungen wie das Basis-Image, das Arbeitsverzeichnis, die zu kopierenden Dateien, die zu installierenden Abhängigkeiten, die freizugebenden Ports und den beim Starten des Containers auszuführenden Befehl enthält.
Stellen Sie sich vor, Sie haben eine in Node.js geschriebene API. Sie könnten eine Dockerfile ähnlich der folgenden erstellen, indem Sie mit einem offiziellen Node-Image beginnen, die Dateien kopieren, die Abhängigkeiten installieren und den Startbefehl definieren :
FROM node:14

WORKDIR /app

COPY . .

RUN npm install

EXPOSE 3000

CMD
Diese Datei gibt an, dass die Anwendung im Verzeichnis /app innerhalb des Containers ausgeführt wird , dass Abhängigkeiten mit npm installiert werden, dass Port 3000 freigegeben wird und dass npm start beim Start des Containers ausgeführt wird.
Um diesen Container zu erstellen und zu starten, führen Sie einfach `docker build` aus dem Projektordner und anschließend `docker run` aus , wobei Sie die Ports für den Zugriff vom Host aus zuordnen, oder verwenden Sie für Anwendungen mit mehreren Containern `docker-compose` :
docker build -t mi-app .

docker run -p 3000:3000 mi-app
Dank dieses Modells wird das klassische Problem „Es funktioniert auf meinem Rechner“ minimiert , da die Laufzeitumgebung mit der Anwendung übertragen wird. Darüber hinaus lässt sich Docker nahtlos in CI/CD-Systeme, private Registries und Orchestrierungstools wie Kubernetes integrieren.
Wichtige Komponenten von Docker und ihre Rolle in Microservices
Bei einer typischen Bereitstellung sprechen wir von einem Docker-Host , dem System (physisch oder virtuell), auf dem Docker installiert ist; darauf läuft die Docker Engine , der Daemon, der Images, Netzwerke, Volumes und den Container-Lebenszyklus verwaltet.
Container enthalten die Anwendung und ihre Abhängigkeiten in einem Image verpackt , sodass jeder Server mit Docker dieses Image konsistent ausführen kann. Diese Konsistenz ist entscheidend, wenn viele Microservices in verschiedenen Umgebungen (Entwicklung, Qualitätssicherung, Produktion usw.) bereitgestellt werden.
Zu den interessantesten Vorteilen von Docker gehören die Portabilität zwischen verschiedenen Umgebungen, die Automatisierung der Bereitstellung, die Modularität der Prozesse sowie die Unterstützung von Ebenen und Versionskontrolle in Images , was das Rückgängigmachen von Änderungen und die Optimierung der Speicherung erleichtert.
Kubernetes: Der Orchestrator zur Steuerung hunderter Container
Wenn man von wenigen Containern auf Dutzende oder Hunderte umsteigt, wird deren manuelle Verwaltung schnell zum Albtraum . Hier kommt Kubernetes ins Spiel, eine Open-Source-Plattform, die für die Orchestrierung von Containern in großem Umfang entwickelt wurde.
Kubernetes automatisiert kritische Aufgaben wie Bereitstellung, Skalierung, Failover, Netzwerkkonfiguration und Speicherung containerisierter Anwendungen. Es ist für den Betrieb in öffentlichen Clouds, privaten Clouds, hybriden Umgebungen und sogar On-Premise-Systemen konzipiert.
Der Schwerpunkt liegt auf der Verwaltung von Clustern, die aus mehreren Knoten (Maschinen) bestehen, auf denen Container ausgeführt werden. Ziel ist es, sicherzustellen, dass sich Anwendungen stets im gewünschten Zustand befinden : Anzahl der Replikate, bereitgestellte Versionen, zugewiesene Ressourcen und Konnektivität zwischen Diensten.
Grundlegende Elemente von Kubernetes
Die kleinste Einheit in Kubernetes ist der Pod . Er repräsentiert eine oder mehrere Containerinstanzen, die gemeinsam ausgeführt werden müssen (z. B. ein Anwendungscontainer und ein Sidecar-Container für die Protokollierung). Pods sind kurzlebig: Sie werden vom Cluster je nach Bedarf erstellt, gelöscht und ersetzt.
Um Ihre Pods zugänglich zu machen, bietet Kubernetes die Service- Ressource an , die als Netzwerkabstraktionsschicht fungiert. Ein Service gruppiert mehrere Pods und stellt eine stabile IP-Adresse, einen DNS-Namen und internen Lastausgleich bereit , sodass Clients die Details jedes einzelnen Pods nicht kennen müssen.
Die Deployment- Ressource definiert, wie Pods bereitgestellt und aktualisiert werden: Anzahl der Replikate, verwendetes Image, angewendete Tags und Aktualisierungsstrategie. Kubernetes stellt sicher, dass die gewünschte Anzahl an Pods stets ausgeführt wird und führt bei Konfigurationsänderungen Rolling Updates oder Rollbacks durch.
Es gibt außerdem Ressourcen wie ConfigMap und Secret , mit denen sich Konfigurationen auslagern und sensible Daten (Passwörter, Token, API-Schlüssel) speichern lassen, ohne sie in die Images einbinden zu müssen. Dies vereinfacht die sichere Konfigurationsverwaltung in verschiedenen Umgebungen erheblich.
Wie man einen Kubernetes-Cluster organisiert
Das Herzstück des Clusters bildet die Kubernetes-Steuerungsebene (Control Plane) , die mehrere Komponenten zur Orchestrierung des gesamten Systems vereint. Dazu gehört der API-Server , der als Gateway für die Clusterverwaltung dient; jede Aktion (Erstellen eines Deployments, Auflisten von Pods, Ändern eines Services) läuft über diese API.
Der Scheduler ist dafür zuständig, zu entscheiden, auf welchem Knoten jeder Pod ausgeführt wird, wobei er die verfügbaren Ressourcen, Affinitäten und Einschränkungen berücksichtigt; während der Controller Manager den Status des Clusters überwacht und Aktionen auslöst, um sicherzustellen, dass die Realität dem entspricht, was Sie in den Manifesten angegeben haben (z. B. das Erstellen neuer Pods, wenn weniger vorhanden sind als angefordert).
Die Zustandsverwaltung erfolgt über etcd , eine verteilte Datenbank, die die Konfiguration und Informationen aller Clusterressourcen speichert. Prozesse wie das kubelet (ein Agent, der den Knoten mit dem API-Server verbindet), der kube-proxy (der den Netzwerkverkehr und den Lastausgleich verwaltet) und die Container-Laufzeitumgebung (Docker, containerd, CRI-O usw.) laufen hingegen auf jedem Worker-Knoten.
Bereitstellung von Microservices in Kubernetes mit YAML-Dateien
Um einen Microservice in Kubernetes bereitzustellen, beschreibt man ihn üblicherweise mit einem YAML-Manifest , in dem man die Bereitstellung (Pod-Vorlage, Image, Ports, Anzahl der Replikate, Labels) und den entsprechenden Service definiert, um ihn innerhalb oder außerhalb des Clusters bereitzustellen.
Ein einfaches Beispiel für die Bereitstellung einer Anwendung namens „my-app“ könnte etwa so aussehen, wobei drei Replikate definiert sind und Port 3000 als Container-Port festgelegt ist:
apiVersion: apps/v1

kind: Deployment

metadata:

name: mi-app

spec:

replicas: 3

selector:

matchLabels:

app: mi-app

template:

metadata:

labels:

app: mi-app

spec:

containers:

- name: mi-app

image: mi-app:latest

ports:

- containerPort: 3000
Dieses Manifest legt fest, dass der Cluster drei laufende Pods mit dem Image „my-app:latest“ bereitstellen muss, die alle mit app=my-app gekennzeichnet sind, damit ein Service sie finden und den Datenverkehr auf sie verteilen kann. Kubernetes kümmert sich automatisch um Skalierung, Aktualisierungen und den Pod-Ersatz im Fehlerfall.
Neben Deployments ist es üblich, ClusterIP-, NodePort- oder LoadBalancer -Dienste zu definieren , je nachdem, ob der Microservice nur innerhalb des Clusters, von den Knoten oder aus dem Internet erreichbar sein soll. Alle diese Konfigurationen werden in Repositories versioniert und nahtlos in CI/CD-Pipelines integriert.
Skalierung, Upgrades und Selbstheilung in Kubernetes
Einer der Hauptgründe für den Einsatz von Kubernetes ist die Möglichkeit, Microservices zu skalieren und zu aktualisieren, ohne die Anwendung zu unterbrechen . Die Anzahl der Replikate lässt sich im Manifest (oder mit einem kubectl-Befehl) ändern, und der Cluster erstellt oder löscht Pods, bis der gewünschte Wert erreicht ist.
Diese Skalierung kann manuell oder automatisch erfolgen, beispielsweise mithilfe des Horizontal Pod Autoscalers (HPA) , der die Anzahl der Replikate dynamisch anhand von Metriken wie CPU- oder Speicherauslastung anpasst. Dadurch wird die Kapazität in Zeiten hoher Nachfrage erhöht und Ressourcen werden bei sinkender Last freigegeben.
Kubernetes verwendet standardmäßig Rolling Updates : Es erstellt Pods mit der neuen Version und entfernt die Pods der vorherigen Version schrittweise, ohne abrupten Abbruch. Sollte etwas schiefgehen, ermöglicht ein Rollback die schnelle Wiederherstellung der vorherigen Version.
Ein weiteres wichtiges Merkmal ist die Selbstheilung : Wenn ein Container oder Pod ausfällt, erstellt Kubernetes ihn automatisch neu; wenn ein Knoten nicht mehr reagiert, werden die betroffenen Pods auf anderen verfügbaren Knoten neu eingeplant, sodass die Anwendung weiterhin betriebsbereit bleibt.
Überwachung und Beobachtbarkeit von Microservices in Kubernetes
Für den effektiven Betrieb einer Microservices-Umgebung reichen Bereitstellung und Skalierung allein nicht aus: Sie benötigen Echtzeit-Einblicke in die Leistung und den Zustand der Dienste . In Kubernetes ist es üblich, Tools wie Prometheus zur Metrikenerfassung und Grafana zur Visualisierung dieser Metriken zu integrieren.
Prometheus ist dafür zuständig, Metriken von den Pods, Nodes und Clusterkomponenten zu erfassen, zu speichern und Ihnen die Möglichkeit zu geben, Warnungen darüber zu definieren; in Kombination mit Grafana können Sie Dashboards erstellen, auf denen Sie CPU-Auslastung, Speicher, HTTP-Fehler, Latenzen, Anzahl der Replikate oder den Knotenstatus auf sehr übersichtliche Weise überwachen können.
Darüber hinaus bietet kubectl Befehle , um den Status von Deployments, Services, Pods und anderen Ressourcen zu überprüfen, Protokolle anzuzeigen , Ereignisse zu beschreiben und auf Container zum Debuggen zuzugreifen. All dies ist Teil einer Observability-Strategie, die in Microservices unerlässlich ist, um ein beruhigendes Gefühl der Sicherheit zu gewährleisten.
Beziehung zwischen Microservices, Docker und Kubernetes
Microservices, Docker und Kubernetes passen zusammen wie Teile desselben Puzzles: Die Microservices-Architektur definiert, wie die Anwendung gestaltet wird, Docker kümmert sich um das Verpacken und Ausführen jedes einzelnen Dienstes, und Kubernetes orchestriert all diese Container in einem Cluster.
Jeder Microservice ist in einem Docker-Image gekapselt, das seinen Code und seine Abhängigkeiten enthält . Dadurch wird sichergestellt, dass er sich auf dem Laptop des Entwicklers, in einer Testumgebung oder in der Cloud-Produktion identisch verhält. Diese einheitliche Paketierung ist ein wesentlicher Bestandteil der DevOps-Philosophie.
Kubernetes fungiert seinerseits als Container-Orchestrator : Es entscheidet, wie viele Instanzen jedes Microservice laufen sollen, wo sie sich befinden, wie der Datenverkehr auf sie verteilt wird, wie sie sich von Ausfällen erholen und wie sie skalieren, wenn die Nachfrage steigt oder sinkt.
In einer E-Commerce-Anwendung könnten Sie beispielsweise Microservices für Authentifizierung, Katalog, Warenkorb und Zahlungen einsetzen, jeweils mit eigenem Docker-Image und Kubernetes-Deployment. So lässt sich der Katalog für umfangreiche Kampagnen oder Zahlungen in kritischen Phasen skalieren, ohne den Rest des Systems zu beeinträchtigen , und sein gesamter Lebenszyklus – von CI/CD-Pipelines bis hin zur Überwachung nach der Produktion – orchestrieren.
Installation von Docker und Kubernetes unter Windows
Wenn Sie mit Windows arbeiten, ist der bequemste Einstieg die Installation von Docker Desktop . Dieses Programm beinhaltet die Docker-Engine und zusätzliche Tools und bietet sogar Optionen zur Integration von Kubernetes in Ihren Rechner.
Der typische Installationsprozess umfasst das Herunterladen von Docker Desktop von der offiziellen Website , das Ausführen des Installationsprogramms (Docker Desktop Installer.exe) und das Folgen des Installationsassistenten. Während der Installation können Sie zwischen Hyper-V und WSL 2 als Virtualisierungstechnologie wählen; falls nur eine der beiden verfügbar ist, wird diese verwendet.
Nach dem Neustart des Systems initialisiert Docker Desktop die Containerumgebung. Falls die Virtualisierung nicht aktiviert war, bietet das Installationsprogramm normalerweise an, sie automatisch zu aktivieren . Anschließend können Sie Container starten, beispielsweise Nginx oder Ihre eigenen Anwendungen.
Um Kubernetes unter Windows zu nutzen, müssen Docker und Virtualisierungsfunktionen aktiviert sein. Anschließend können Sie Kubernetes über Docker Desktop aktivieren oder kubectl installieren und konfigurieren, um externe Cluster zu verwalten und gegebenenfalls das Kubernetes-Dashboard mithilfe eines Remote-Manifests bereitzustellen.
Nach der Konfiguration können Sie über einen lokalen Proxy auf das Dashboard zugreifen. Dazu verwenden Sie ein mit kubectl generiertes Authentifizierungstoken, das beispielsweise auf die Konfigurationsdatei .kube/config verweist , um den Zugriff auf den Cluster vom Browser aus zu verwalten.
Installation von Docker und Kubernetes unter Linux
Auf Linux-Systemen wie Ubuntu ist die Installation von Docker in der Regel recht unkompliziert: Man aktualisiert die Pakete, installiert die Docker-Engine und überprüft die korrekte Funktion der Umgebung durch Ausführen eines Testcontainers.
Zu den typischen Schritten gehören das Aktualisieren des Systems mit `apt-get update` und `apt-get upgrade` , das Entfernen aller vorhandenen vorherigen Versionen von Docker Desktop und anschließend die Installation von docker-ce, docker-ce-cli, containerd.io und des docker-compose-Plugins aus den offiziellen Repositories oder durch Angabe der gewünschten Version.
Um zu überprüfen, ob alles korrekt funktioniert, wird üblicherweise ein „Hello-World“-Container gestartet, der ein minimales Image herunterlädt und ausführt . Wird die Meldung korrekt angezeigt, ist Docker betriebsbereit und Sie können mit der Containerisierung Ihrer Microservices beginnen.
Kubernetes lässt sich unter Linux mithilfe von Tools wie kubeadm installieren . Der typische Workflow umfasst das Hinzufügen des Kubernetes-Repository-Schlüssels, das Konfigurieren der Paketlistendatei, die Installation von kubeadm und die Überprüfung seiner Version.
Anschließend wird der Cluster auf dem Master-Knoten mit kubeadm init initialisiert (wobei der Netzwerkbereich für die Pods angegeben wird), der Befehl „join“ wird abgerufen, damit die Worker-Knoten dem Cluster beitreten, und der lokale Zugriff wird konfiguriert, indem das Verzeichnis $HOME/.kube erstellt , die Datei admin.conf kopiert und die Berechtigungen angepasst werden.
Damit verfügen Sie über einen Basiscluster, mit dem Sie containerisierte Microservices bereitstellen , ein Netzwerk von Pods (Flannel, Calico usw.) installieren und mit Deployments, Services und den übrigen Kubernetes-Ressourcen arbeiten können.
Bewährte Verfahren und Empfehlungen für die Verwendung von Docker und Kubernetes
Um das Potenzial dieser Umgebungen optimal auszuschöpfen, empfiehlt es sich, eine Reihe bewährter Vorgehensweisen mit Docker zu befolgen. Dazu gehört die Verwendung offizieller oder vertrauenswürdiger Images , entweder von Docker Hub oder aus verifizierten privaten Repositories, um Sicherheitsrisiken zu minimieren.
Es wird dringend empfohlen, die Image-Größe durch die Verwendung schlanker Basis-Images, mehrstufige Builds und das Entfernen unnötiger temporärer Dateien oder Artefakte zu optimieren . Kleinere Images werden schneller heruntergeladen und beschleunigen Kubernetes-Bereitstellungen.
Ein weiterer wichtiger Punkt ist die Verwendung von Volumes zur Datenpersistenz , anstatt Informationen in Containern zu speichern, damit der Verlust oder die Neuerstellung eines Containers nicht zum Verlust wichtiger Daten führt.
Die Begrenzung der jedem Container zugewiesenen Ressourcen (CPU, Arbeitsspeicher, E/A) verhindert, dass ein einzelner Dienst den Host monopolisiert und die Leistung anderer beeinträchtigt. Zusätzlich sollten Container mit Tools wie Docker Stats oder fortgeschritteneren Lösungen überwacht werden, um die Kontrolle im Produktivbetrieb zu gewährleisten.
Bei Kubernetes ist es unerlässlich, die Clusterarchitektur und ihre Komponenten vor dem Produktiveinsatz zu verstehen. Das erspart viele Probleme.
Es ist außerdem ratsam, so viel wie möglich zu automatisieren : Verwenden Sie Replikationscontroller, Autoscaler und Jobs für Batch-Uploads; nutzen Sie Rolling Updates und Rollbacks; und definieren Sie versionierte deklarative Manifeste in Git-Repositories.
Sicherheit muss immer oberste Priorität haben: Beschränkung des Zugriffs auf den API-Server, Verwaltung von Anmeldeinformationen mithilfe von Secrets, Verschlüsselung von Daten während der Übertragung und im Ruhezustand , regelmäßiges Einspielen von Patches und Definition von Netzwerkrichtlinien, die die Kommunikation zwischen Diensten nach dem Prinzip der minimalen Berechtigungen einschränken.
Schließlich ist es unerlässlich, über gute zentrale Überwachungs- und Protokollierungssysteme sowie Vorproduktionsumgebungen zu verfügen, in denen Änderungen gründlich getestet werden können, bevor sie im Produktionscluster eingesetzt werden, um Risiken und unangenehme Überraschungen zu reduzieren.
Dieses gesamte Ökosystem aus Microservices, Docker-Containern und Kubernetes-Orchestrierung ermöglicht den Aufbau von Systemen, die deutlich flexibler, skalierbarer und ausfallsicherer sind als herkömmliche monolithische Architekturen. Durch die Kombination einer durchdachten Architektur, geeigneter Tools und bewährter DevOps-Praktiken lassen sich Anwendungen bereitstellen, die sich nahtlos an veränderte Arbeitslasten anpassen, schnell von Ausfällen genesen und sich im Laufe der Zeit leichter weiterentwickeln lassen.


Leidenschaftlicher Autor über die Welt der Bytes und der Technologie im Allgemeinen. Ich liebe es, mein Wissen durch Schreiben zu teilen, und genau das werde ich in diesem Blog tun und Ihnen die interessantesten Dinge über Gadgets, Software, Hardware, technologische Trends und mehr zeigen. Mein Ziel ist es, Ihnen dabei zu helfen, sich auf einfache und unterhaltsame Weise in der digitalen Welt zurechtzufinden.
Index
- 1 Was ist eine Microservices-Architektur und wie unterscheidet sie sich von einer monolithischen Architektur?
- 2 Reale Vorteile und Herausforderungen von Microservices
- 3 Container: Die Grundlage für den isolierten Betrieb von Microservices
- 4 Docker: Die Referenzplattform für die Containerisierung von Microservices
- 5 Kubernetes: Der Orchestrator zur Steuerung hunderter Container
- 6 Beziehung zwischen Microservices, Docker und Kubernetes
- 7 Installation von Docker und Kubernetes unter Windows
- 8 Installation von Docker und Kubernetes unter Linux
- 9 Bewährte Verfahren und Empfehlungen für die Verwendung von Docker und Kubernetes