- En un SSD NVMe, un namespace és un conjunt lògic de blocs (LBA) que l'amfitrió veu com un dispositiu independent, gestionat mitjançant ordres de creació, esborrat i associació.
- Linux exposa cada namespace com a /dev/nvmeXnY, sobre el qual es poden crear particions, sistemes de fitxers o utilitzar-lo com a bloc cru, gestionant permisos a nivell de dispositiu.
- Els namespaces també són un mecanisme del nucli per aïllar recursos (PID, xarxa, muntatges, usuaris, etc.), base de contenidors i sandboxs com Docker, Podman o Flatpak.
- A Kubernetes, els namespaces organitzen i aïllen recursos lògics del clúster, permetent multitenancy, control d'accés per RBAC i quotes de recursos dins d'un mateix clúster físic.

Quan comences a ficar-te de debò amb emmagatzematge modern, NVMe i Linux , és normal que t'exploti una mica el cap: namespaces, particions, LVM, contenidors, Kubernetes… Sembla que tot fa servir la mateixa paraula, però no sempre significa el mateix. Aquí centrarem el tir en què són els namespaces en un SSD NVMe , com es veuen des de Linux i, ja que el terme es reutilitza, veurem també com encaixen els namespaces al kernel de Linux ia Kubernetes perquè no els confonguis més.
La idea és construir una imatge completa: des del que passa físicament dins un SSD NVMe amb namespaces lògics, passant per com s'exposen com a dispositius /dev/nvme0n1 a Linux, com es gestionen amb eines com nvme-cli, i acabant amb el concepte de namespaces a nivell de sistema (IPC, PID, xarxa, etc.) i en orquestradors com Kubernetes. Tot això amb un enfocament pràctic, proper i, sobretot, sense deixar-te cap serrell solt.
Què és realment un namespace en un SSD NVMe
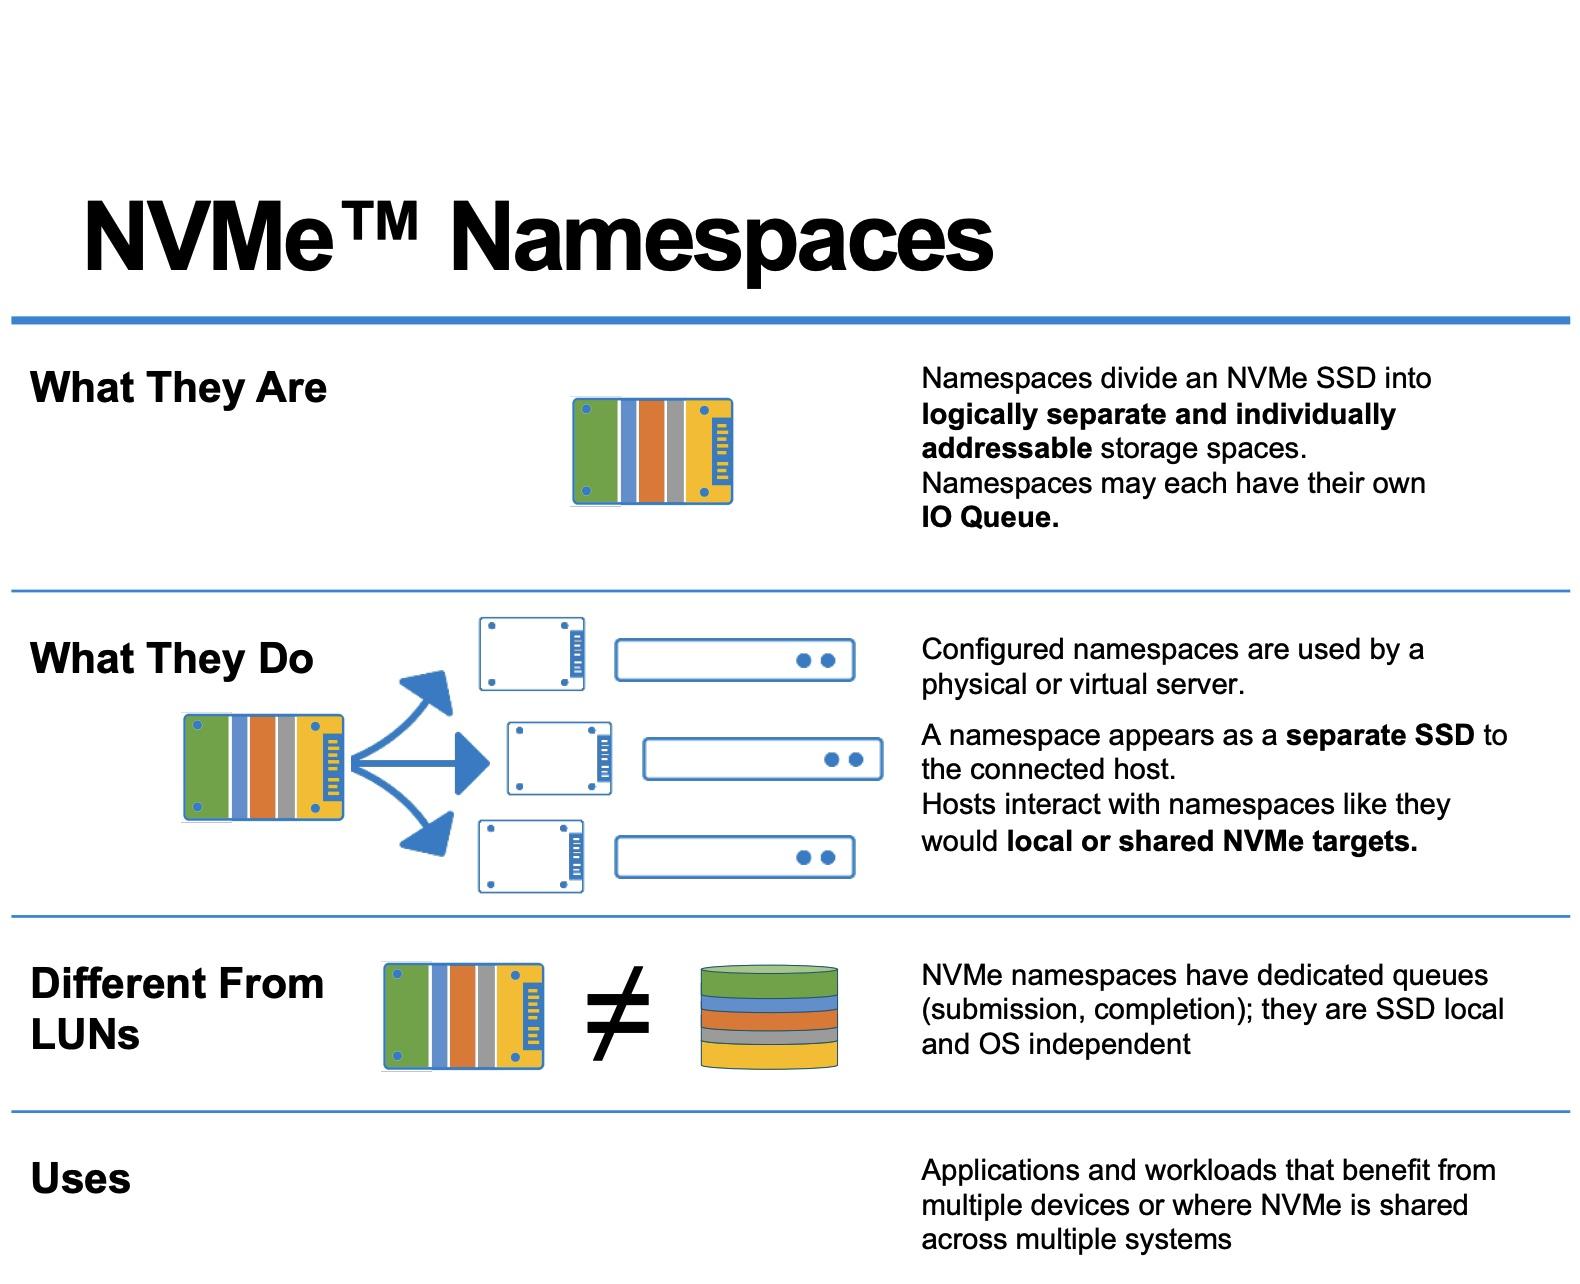
A la tecnologia NVMe un namespace és, literalment, un conjunt d' adreces de bloc lògiques (LBA, Logical Block Addresses) que el sistema operatiu pot veure com si fos un dispositiu de bloc independent. No és un tros físic separat de NAND, sinó una separació lògica dins del SSD.
Quan el fabricant configura el disc, el controlador NVMe organitza la memòria flaix en un o més namespaces. Cadascú s'identifica mitjançant un NSID (Namespace ID) i el controlador s'encarrega d'exposar aquests namespaces al sistema amfitrió. Cada namespace es presenta al sistema com una destinació independent, cosa que permet que un mateix SSD sembli, a ulls del sistema, diversos “discos” diferents.
A Linux, cada namespace apareix com un dispositiu de bloc tipus /dev/nvmeXnY, on X és l'índex del controlador (per exemple, 0) i Y és l'ID del namespace (per exemple, 1). Així, /dev/nvme0n1 indica “controladora NVMe 0, namespace 1”. Aquest dispositiu es pot tractar com qualsevol altre disc: es pot particionar, formatar, afegir a LVM, utilitzar com a volum cru, etc.
Un detall important és que, en la majoria d'unitats, per defecte hi ha un únic namespace la mida del qual abasta tota la capacitat utilitzable de l'SSD. No obstant això, l'estàndard NVMe permet esborrar aquest namespace i recrear-ne diversos, cadascun amb la seva mida pròpia i certes propietats particulars, com un format de LBA concret o polítiques de seguretat específiques.
Grandària, capacitat i ús d'un namespace NVMe
L'estàndard NVMe defineix una estructura anomenada Identify Namespace que conté diverses mètriques crítiques: grandària, capacitat i utilització de cada namespace. Aquesta informació la pots consultar amb eines com nvme-cli mitjançant la comanda nvme id-ns i també amb programes per diagnosticar discs durs i SSD.
Dins aquesta estructura destaquen tres camps clau: NSZE, NCAP i NUSE . Entendre'ls bé és fonamental per controlar com utilitzes realment l'espai dins de cada namespace i com respon la unitat a operacions d'esborrament lògic (TRIM o Deallocate).
El camp Namespace Size (NSZE) indica el nombre total de blocs lògics que componen el namespace, numerats des de LBA 0 fins a LBA n-1. És, per dir-ho així, la mida nominal del namespace: la quantitat d'adreces de bloc que el host veu com disponibles, independentment que estiguin o no assignades internament.
El camp Namespace Capacity (NCAP) marca el màxim de blocs que el dispositiu permet tenir realment assignats en un moment donat. Encara que sembli el mateix que NSZE, no ha de coincidir: la capacitat pot ser menor que la mida oficial del namespace, cosa que obre la porta a tècniques de gestió avançada d'espai i sobreaprovisionament intern.
Finalment, el camp Namespace Utilization (NUSE) reflecteix quants blocs lògics estan efectivament assignats ara mateix. Després d'un format complet, NUSE hauria de ser zero; a mesura que es van escrivint dades, aquest valor augmenta i només torna a baixar quan el sistema envia ordres d'alliberament de blocs (TRIM o Deallocate). Aquest indicador és molt útil per a aplicacions i sistemes que volen saber si el dispositiu està atenent correctament les peticions d'alliberament d'espai.
Format de blocs i altres capacitats del namespace
A més de la mida i l'ús, cada namespace descriu, a través de l'ordre Identify , quins formats de LBA suporta, quines mides de bloc són òptims i si disposa de funcions addicionals com a protecció d'extrem a extrem o diferents modes de seguretat. Aquesta informació la fan servir els sistemes operatius i les aplicacions per ajustar la mida de les operacions de lectura/escriptura i aprofitar al màxim el maquinari.
Un mateix SSD pot acceptar un o més formats de LBA (per exemple, 4 KiB, 8 KiB, etc.). En alguns models, tots els namespaces han de compartir el mateix format; en altres, és possible que cada namespace tingui una mida de bloc diferent. Això és especialment útil quan es combinen càrregues de treball diverses, on un namespace està optimitzat per a I/O de fitxers petits i un altre per a grans lectures seqüencials.
L'estructura d'identificació també indica si el namespace admet informació de protecció (Protection Information, PI), és a dir, metadades addicionals que permeten verificar la integritat de les dades al llarg de tot el camí, des de l'aplicació fins a la NAND, i reduir la probabilitat de corrupció silenciosa.
Convé subratllar que un mateix namespace pot estar associat a una o diverses controladores NVMe dins del mateix subsistema. Si només està lligat a una controladora, es parla de namespace privat; si s'adjunta a diverses, s'anomena namespace compartit. Aquesta flexibilitat és essencial en entorns d'alta disponibilitat i cabines d'emmagatzematge NVMe-OF (NVMe over Fabrics).
Gestió de namespaces: creació, esborrament i associació
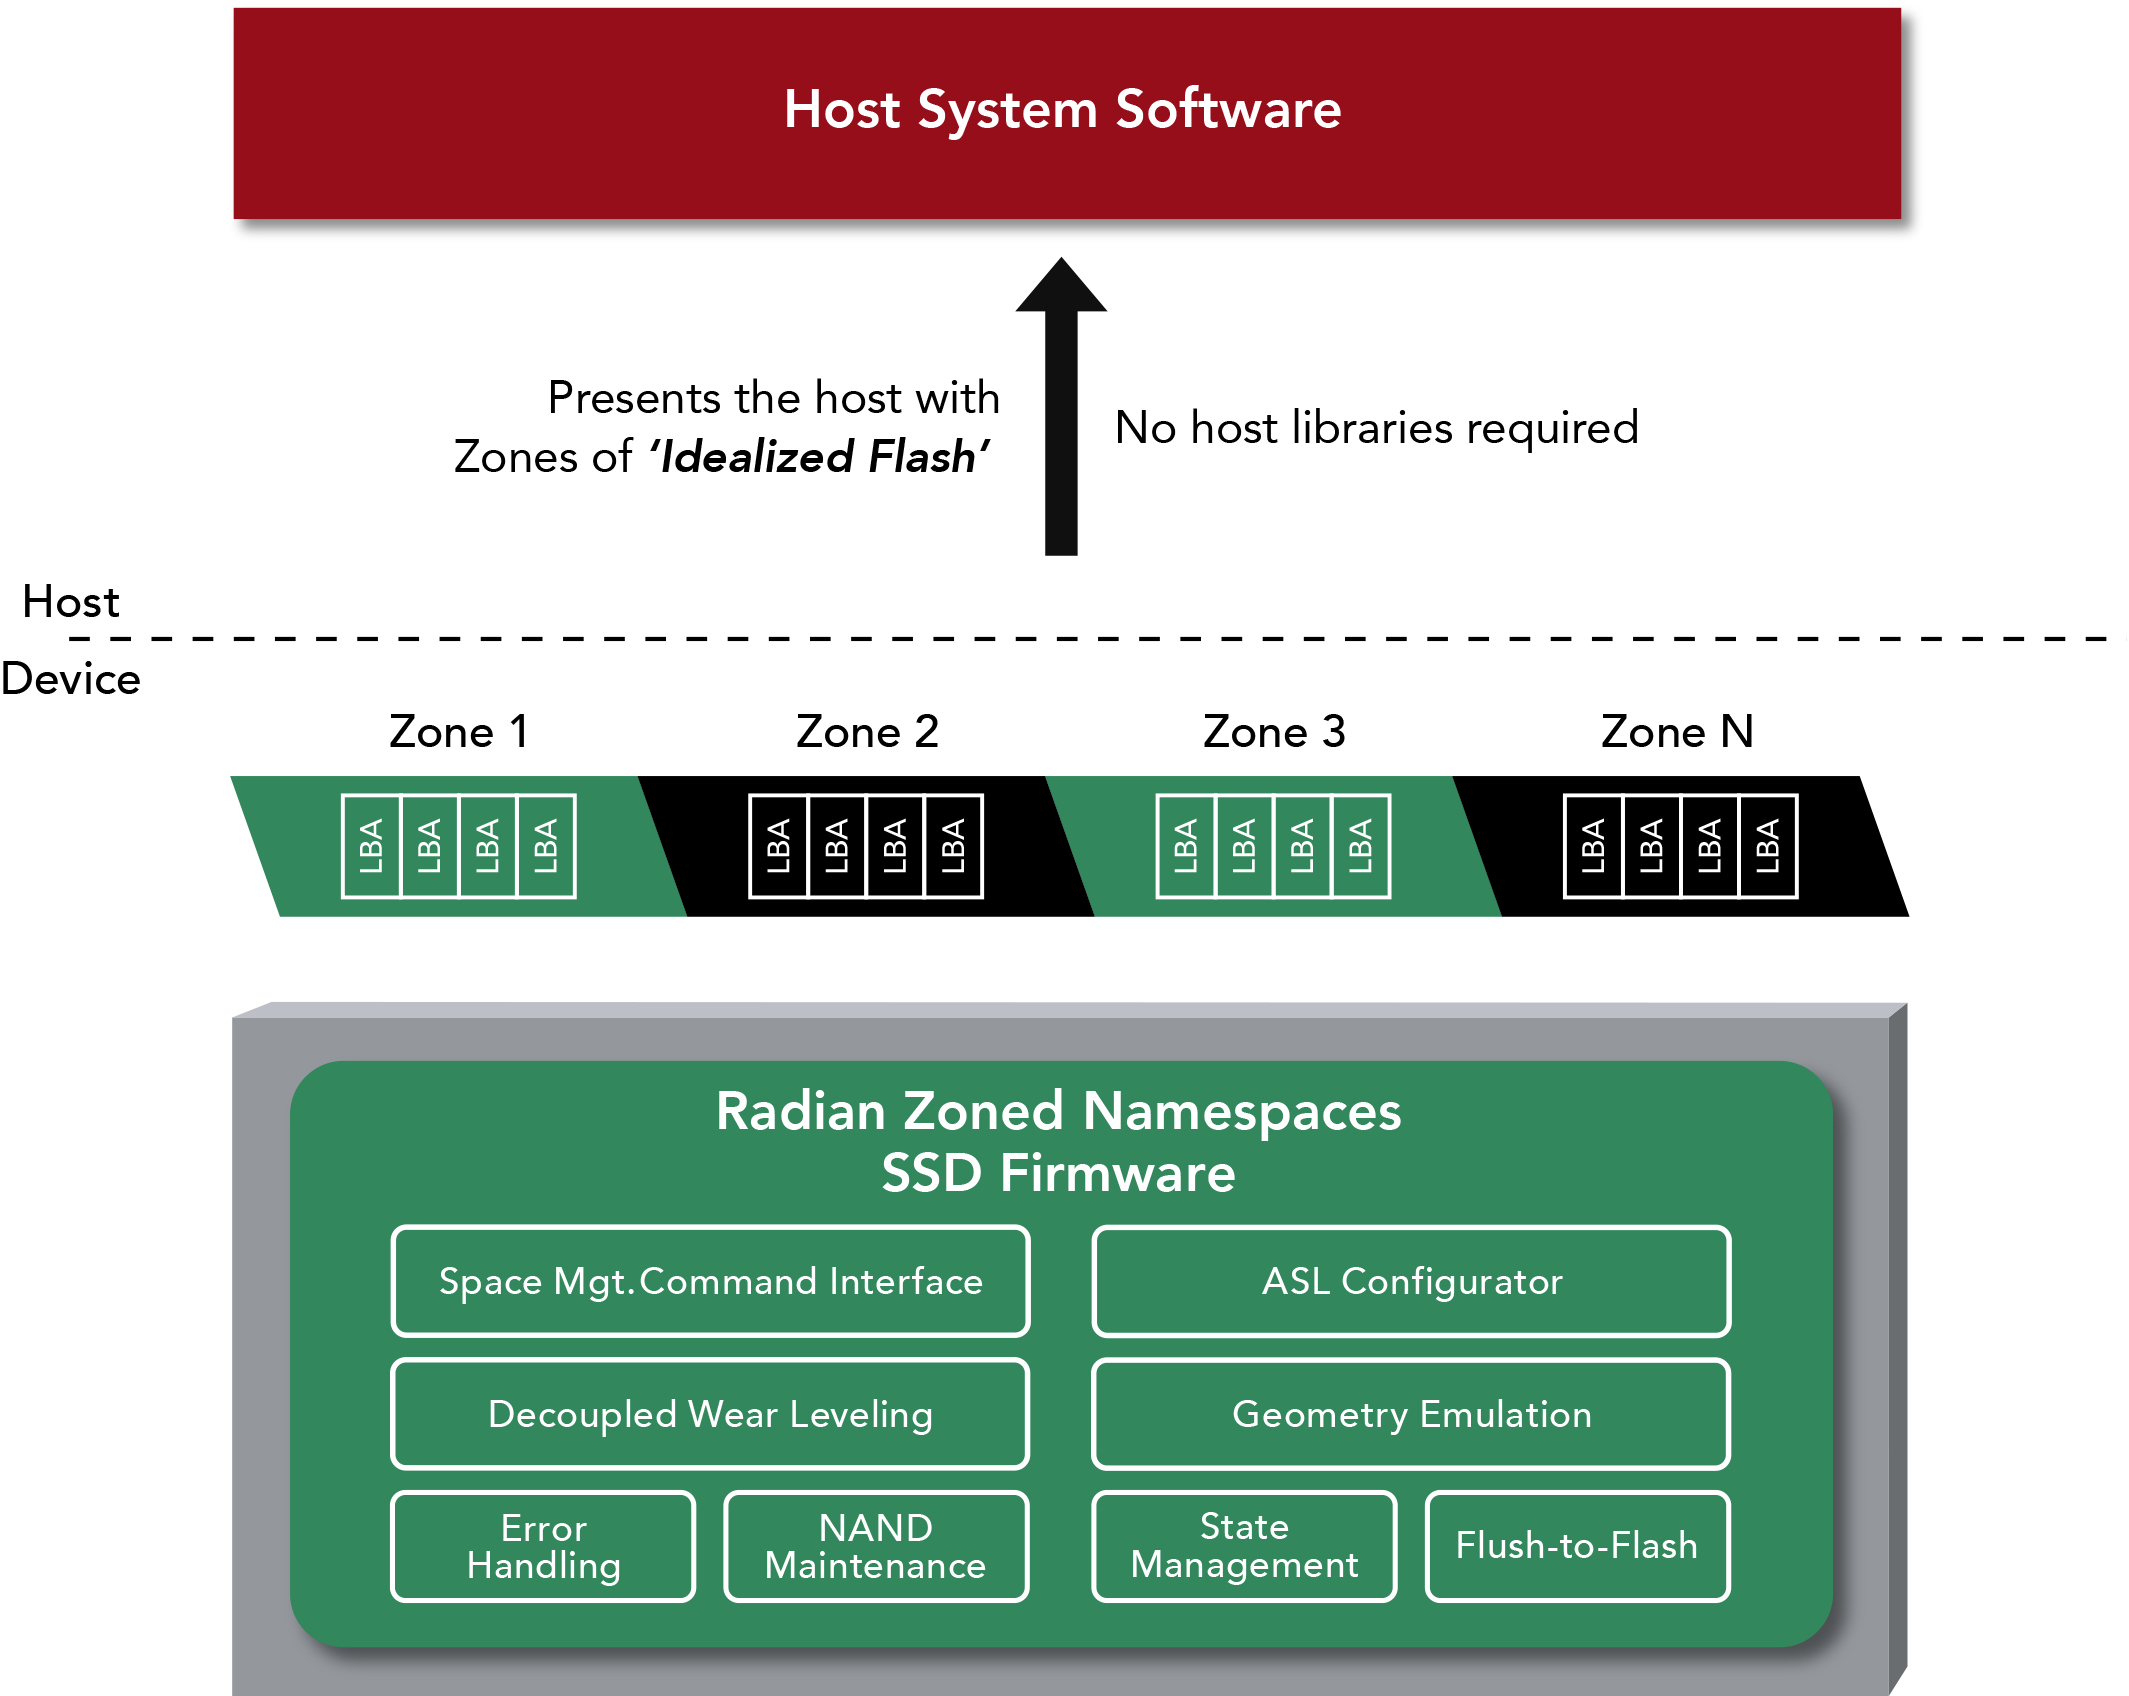
L'especificació NVMe inclou dos grans grups d'ordres per gestionar namespaces: gestió (Management) i associació (Attachment) . Amb el primer podeu crear, modificar i eliminar namespaces; amb el segon, adjunteu-los o separeu-los d'una o diverses controladores del subsistema.
El flux típic és el següent: primer el host crea un namespace amb els paràmetres desitjats (mida, capacitat, format de LBA, etc.). En aquest moment el namespace encara no és visible com a dispositiu de bloc per al sistema operatiu. Perquè aparegui, cal executar una ordre d' attach , que la vincula a una controladora concreta oa diverses. Després d'un reset de la controladora o un redescobriment, el sistema s'acabarà exposant com un dispositiu /dev/nvmeXnY.
També es pot seguir el camí invers: desvincular un namespace existent dels controladors per deixar d'exposar-lo al host i, a continuació, esborrar-lo del tot. Això és el que se sol fer quan es vol recrear la distribució de namespaces en una unitat, per exemple, per canviar el percentatge de sobreaprovisionament o per reorganitzar el repartiment entre diferents tenants.
A Linux, l'eina de referència per això és nvme-cli. Amb ella pots llistar namespaces (nvme list), consultar detalls amb Identify, crear nous namespaces (nvme create-ns), adjuntar-los (nvme attach-ns), separar-los (nvme detach-ns) i esborrar-los (nvme delete-ns). Aquestes operacions solen requerir privilegis d'administrador i s'han de planificar bé, ja que impliquen canvis profunds al layout de la unitat. A més, és recomanable mantenir el firmware actualitzat.
Quan es treballa amb diversos namespaces a la mateixa unitat, és habitual utilitzar namespaces privats per a entorns aïllats (per exemple, un host concret) i namespaces compartits per a arquitectures més complexes, on diversos hosts accedeixen coordinadament a les mateixes dades a través d'un subsistema NVMe-oF.
Per què dividir un SSD NVMe en múltiples namespaces
Pot semblar que el més senzill és deixar el SSD amb un únic namespace que ocupi tota la capacitat, però hi ha raons de pes per crear-ne diversos. Entre les més habituals destaquen la separació lògica de clients, la millora de la seguretat i l'ajustament fi de rendiment i durabilitat.
En escenaris de multitenancy , per exemple en proveïdors de serveis al núvol o grans plataformes, un mateix SSD físic pot allotjar les dades de diversos clients. Mitjançant namespaces, cada tenant obté el seu “disc lògic” aïllat. Això simplifica força la gestió, la facturació i el disseny de SLA, sense obligar a repartir físicament la NAND.
Un altre motiu freqüent és la seguretat i el xifrat per namespace . Moltes unitats NVMe compatibles amb OPAL permeten definir polítiques de xifratge sobre rangs de LBA. Si es treballa amb un únic namespace, es poden configurar diversos rangs protegits dins seu; però si es creen namespaces separats per a diferents grups de dades, és possible aplicar diferents claus i regles de xifrat per namespace, alineades amb el nivell de sensibilitat de cada conjunt dinformació.
També hi ha el cas dels entorns amb requisits de rendiment molt diferents a la mateixa màquina. Un namespace es pot reservar per a una base de dades crítica, amb un percentatge de sobreaprovisionament alt per minimitzar la latència i millorar la resistència, mentre que un altre namespace serveix per a dades menys exigents en I/O. Aquesta separació ajuda a evitar que una càrrega de treball sorollosa degrade lexperiència duna altra més sensible.
A més, els namespaces permeten aplicar polítiques de només lectura a dades importants, per exemple, un sistema operatiu encastat o una imatge d' arrencada en productes mòbils, entorns d'alta seguretat o sistemes industrials. El NVMe pot marcar un namespace com de només lectura temporal (fins al següent cicle d'energia), fins que el bloqueig es tregui i es reiniciï, o fins i tot deixar-lo permanentment en mode lectura per a tota la vida útil del disc.
Sobreaprovisionament i ajustament fi per namespace
Els SSD sempre reserven internament certa quantitat de memòria flaix no visible per al sistema, que s'usa com a espai de sobreaprovisionament per a tasques internes com garbage collection, anivellat de desgast i gestió de blocs defectuosos. Tot i això, en jugar amb la mida dels namespaces, l'administrador pot influir en quant de la NAND queda sense assignar al host i, per tant, disponible com a reserva interna.
Si es crea un namespace notablement més petit que la quantitat total de flaix física, s'està deixant una fracció més gran de memòria sense exposar al host. Com més sobreaprovisionat queda el dispositiu, millor sol ser l'estabilitat de rendiment i més gran la resistència en cicles d'escriptura, cosa fonamental en càrregues de treball intensives en escriptures.
Per exemple, imagina un SSD de 7,68 TB al qual es defineix un namespace utilitzable d'aproximadament 6,14 TB. La resta queda oculta al host i passa a engrossir el “matalàs” de sobreaprovisionament. Amb eines com nvme-cli és possible esborrar els namespaces anteriors, recrear-los amb la mida desitjada i adjuntar-los de nou a les controladores per aconseguir exactament aquest efecte.
Un dels reptes en aquest procés és ajustar adequadament la granularitat de mida i capacitat del namespace . L'estàndard contempla que tant NSZE com NCAP es manegin en unitats que no han de coincidir exactament amb la mida lògica de bloc, cosa que pot provocar que quedin petites porcions de memòria no direccionables si no es trien bé els valors. L'objectiu és minimitzar aquest espai “perdut” perquè el namespace quedi tan rodó com sigui possible.
Durant la creació del namespace, cal tenir en compte les restriccions del dispositiu que reporta el propi dispositiu. Ajustant els valors de NSZE i NCAP en funció d'aquests factors, es pot aconseguir que gairebé tota la memòria física quedi correctament aprofitada, ja sigui com a espai accessible per l'amfitrió o com a sobreaprovisionament intern útil per al controlador.
Namespaces, particions Linux, LVM i accés directe al bloc
Des de la perspectiva del Linux, cada namespace NVMe apareix com un dispositiu de bloc base tipus /dev/nvme0n1 . A partir d'aquí, l'administrador pot decidir com fer-lo servir: deixar-lo sense particions per a I/O directe, particionar-lo com un disc clàssic o integrar-lo en LVM o en altres sistemes de gestió de volums.
Quan es creen particions sobre aquest namespace, el nucli les exposa com a /dev/nvme0n1p1, /dev/nvme0n1p2 , etc. El sufix “p” indica precisament que és una partició del namespace, igual que /dev/sda1 és una partició de /dev/sda. Sobre aquestes particions es poden muntar sistemes de fitxers, fer-les servir en LVM, RAID per programari, etc.
Si el que busqueu és exposar emmagatzematge de bloc “cru” directament a una base de dades oa un sistema d'emmagatzematge distribuït, és habitual treballar contra el dispositiu del namespace sense particions, o bé contra una partició dedicada, però sense sistema de fitxers a sobre. En aquests casos, laplicació sol parlar directament en termes de blocs lògics i gestionar el seu propi espai intern.
Convé tenir en compte que no és trivial dividir un namespace que ja està en ús amb particions sense afectar les dades. Per modificar el layout de namespaces, el normal és donar suport a la informació, desmuntar, esborrar el namespace i crear-los de nou amb la mida desitjada, la qual cosa implica una planificació acurada en entorns de producció.
Quant als permisos, un dispositiu de bloc sense sistema de fitxers es controla, com qualsevol altre node a /dev, mitjançant propietari, grup i mode d'accés. A més d'això, es poden fer servir ACLs, regles d'udev i mecanismes de control d'accés del propi sistema (per exemple, grups especials per a accés a discos) per decidir quins usuaris o serveis poden llegir i escriure sobre un namespace o una de les particions.
Namespaces del nucli de Linux: aïllament de recursos del sistema
La paraula namespace no només es fa servir en el context de NVMe. El nucli de Linux ofereix un mecanisme amb el mateix nom, però orientat a aïllar recursos del sistema per a processos . Aquesta funcionalitat és la base de tecnologies com a contenidors Docker, Podman, LXC o sandboxes tipus Flatpak i bubblewrap.
En aquest cas, un espai de noms envolta un recurs global (punts de muntatge, pila de xarxa, PIDs, usuaris, hostname, rellotges, etc.) en una abstracció que fa que els processos que hi viuen vegin la seva pròpia instància aïllada del recurs. Els canvis realitzats des de dins del namespace només són visibles per als processos que comparteixen aquest mateix espai de noms.
Linux suporta actualment diversos tipus de namespaces: cgroup, ipc, mnt (mount), net, pid, user, uts i time . Cadascú aïlla un aspecte concret del sistema. Per exemple, el namespace de xarxa permet que un contenidor tingui les vostres pròpies interfícies i taules d'encaminament, mentre que el namespace de PID us dóna la vostra pròpia numeració de processos començant a 1.
Per inspeccionar a quins namespaces pertany un procés concret, només cal mirar els enllaços simbòlics a /proc/<PID>/ns/. Cada enllaç apunta a un identificador de namespace, que es pot compartir amb altres processos (si estan al mateix espai) o ser diferent (si té un entorn aïllat).
Eines com bubblewrap (bwrap) , utilitzada per Flatpak, es recolzen precisament en aquests mecanismes. Bwrap crea sandboxes llançant processos amb namespaces separats per a muntatge, PID, usuari, xarxa, etc., de manera que l'aplicació s'executa en un entorn acotat on només veieu els recursos que se us han concedit.
Si vols trastejar amb namespaces de Linux sense instal·lar res estrany, tens a la teva disposició ordres del propi sistema com unshare y nsenter. Són molt útils per entendre què està passant per sota quan executes contenidors o aplicacions sandbox.
Amb unshare pots llançar un procés nou amb un o diversos namespaces aïllats: per exemple, un intèrpret d'ordres que té el seu propi conjunt de PIDs i usuaris. En executar-ho amb opcions com –user, –pid i –fork, obtindràs una sessió on el procés que corre dins veu el PID 1 com a propi i, a més, s'executa amb un usuari diferent (per exemple, ningú), el que subratlla aquest aïllament.
En aquests entorns, és important muntar un /proc nou i aïllat usant l'opció –mount-proc. Si no es fa, algunes utilitats que depenen de /proc/<PID>/exe poden fallar perquè intenten veure informació de processos segons el namespace del host, i el nucli bloqueja aquest accés per mantenir l'aïllament de seguretat.
També cal tenir en compte que, si unshare no fa servir –fork, podria executar la comanda dins del mateix procés i provocar errors curiosos, com la impossibilitat de muntar /proc adequadament o fallades d'assignació de memòria, ja que el procés no assumeix el rol correcte de PID 1 dins del nou namespace.
D'altra banda, nsenter fa el camí invers: et permet “entrar” als namespaces d'un procés ja existent. És el que se sol fer per examinar des del host com veu el món un contenidor o una aplicació Flatpak. Un cop dins, pots inspeccionar la seva pila de xarxa, els seus punts de muntatge, la taula de processos interna, etc., com si estiguessis “dins” del contenidor.
Namespaces i contenidors: de Flatpak a Podman i Docker
Un cop entens els namespaces del kernel, és fàcil veure com els contenidors no són màgia, sinó composició de diverses primitives : namespaces per aïllar recursos, cgroups per limitar consum, capacitats per controlar privilegis i sistemes de fitxers en capes per empaquetar aplicacions.
Flatpak utilitza bubblewrap per crear entorns aïllats per a aplicacions descriptori. Cada aplicació corre en un conjunt de namespaces on es restringeixen les rutes a què pot accedir, la visibilitat de processos, la xarxa, etc. A nivell de procés, es veu clarament que els PIDs, mount points i, sovint, l'usuari difereixen dels del sistema amfitrió.
De forma similar, eines com LXC, Docker o Podman componen diferents namespaces per construir contenidors dús general. Per exemple, un contenidor rootless pot utilitzar un namespace d'usuari per mapejar IDs interns a IDs sense privilegis al host, i un namespace de xarxa per tenir interfícies virtuals dedicades. Analitzant el PID del procés de contenidor al host i entrant amb nsenter, es pot comprovar de primera mà aquest aïllament.
Per a situacions on es vol crear namespaces “rootless” de forma més còmoda, es pot recórrer a eines com rootlesskit , que ajuden a configurar tot el tinglado necessari perquè un usuari sense privilegis pugui crear entorns aïllats sense accés directe a root , una cosa cada cop més demandada en entorns multiusuari moderns.
Namespaces a Kubernetes: clústers virtuals lògics
El terme namespace torna a aparèixer a Kubernetes, però aquí fa referència a un mecanisme lògic per segmentar recursos dins un únic clúster . No té res a veure amb adreces de bloc NVMe ni amb aïllament a nivell de kernel, encara que conceptualment també es fa servir per separar i organitzar.
A Kubernetes, un namespace és com un clúster virtual dins del clúster físic . Serveix per agrupar recursos (pods, serveis, deployments, etc.) de manera que es puguin gestionar i aïllar per equips, projectes o entorns (desenvolupament, proves, producció) sense necessitat d'aixecar diversos clústers reals.
Aquests espais de noms permeten que hi hagi recursos amb el mateix nom en contextos diferents . Per exemple, pots tenir un servei anomenat mi-servei al namespace desenvolupament i un altre amb el mateix nom en producció sense conflicte, perquè la unicitat es garanteix només dins de cada namespace.
A més, els namespaces de Kubernetes s'integren amb RBAC (role-based access control) . És possible definir permisos que limiten quins usuaris o comptes de servei poden crear, modificar o llegir recursos en un namespace determinat, cosa que facilita moltíssim la delegació segura entre diferents equips o organitzacions compartint infraestructura.
Una altra peça clau són les quotes de recursos . Kubernetes permet restringir, per namespace, la quantitat de CPU, memòria, objectes (com pods) i altres recursos que poden consumir les càrregues de treball. D'aquesta manera, s'evita que un projecte es “mengi” tot el clúster i es fomenta un ús més predictible i just.
Funcionament pràctic de namespaces a Kubernetes
En un clúster recentment instal·lat, Kubernetes sol crear diversos namespaces per defecte: default, kube-system i kube-public . El primer es fa servir per a recursos que no especifiquen namespace; el segon està destinat a components interns del sistema; el tercer, accessible fins i tot per a usuaris no autenticats, es reserva per a certs elements que necessiten ser llegits públicament a nivell de clúster.
Per veure els namespaces disponibles, es pot fer servir kubectl get namespaces o la seva abreviatura. A partir d´aquí, l´administrador pot crear i esborrar namespaces segons ho necessiteu, normalment seguint una estratègia d'organització per projectes o entorns (per exemple, dev, posada en escena, producció).
Quan es llança una ordre amb kubectl, es pot indicar temporalment el namespace objectiu mitjançant l'opció –namespace, o bé configurar un context per defecte que faci que totes les operacions apuntin a un namespace determinat, cosa que estalvia errors i t'evita escriure l'opció a cada ordre.
Quant a DNS, Kubernetes registra els serveis usant un nom complet de l'estil <service-name>.<namespace>.svc.cluster.local . Dins d'un mateix namespace, només cal utilitzar el nom simple del servei i la resolució DNS farà la resta. Però si des d'un pod en un namespace voleu accedir a un servei d'un altre namespace, heu d'utilitzar el FQDN complet o un nom parcial que inclogui almenys servei i namespace.
No tots els objectes de Kubernetes viuen dins un namespace. Els propis namespaces, els nodes o els volums persistents són recursos a nivell de clúster i no estan encapsulats dins un namespace. Això és important per entendre quins recursos se segmenten lògicament i quins es consideren globals.
En general, es recomana començar a utilitzar namespaces quan el clúster ja té un nombre considerable d'usuaris i aplicacions , o quan necessites aïllament clar entre equips. Per a diferències menys profundes (com versions d'una aplicació) sol ser millor fer servir etiquetes dins d'un mateix namespace que multiplicar innecessàriament el nombre de namespaces.
Si ajuntem totes aquestes peces —namespaces a SSD NVMe per segmentar adreces de bloc, namespaces del kernel per aïllar recursos de processos i namespaces a Kubernetes per organitzar lògicament els recursos del clúster— es veu que la mateixa paraula es reutilitza per idees emparentades: crear dominis separats dins d'un espai compartit , cadascun. Entendre bé en quina capa ets a cada moment és el que marca la diferència entre un sistema ordenat i un impossible de mantenir.
Índex
- 1 Què és realment un namespace en un SSD NVMe
- 2 Grandària, capacitat i ús d'un namespace NVMe
- 3 Format de blocs i altres capacitats del namespace
- 4 Gestió de namespaces: creació, esborrament i associació
- 5 Per què dividir un SSD NVMe en múltiples namespaces
- 6 Sobreaprovisionament i ajustament fi per namespace
- 7 Namespaces, particions Linux, LVM i accés directe al bloc
- 8 Namespaces del nucli de Linux: aïllament de recursos del sistema
- 9 Experiments pràctics amb unshare i nsenter
- 10 Namespaces i contenidors: de Flatpak a Podman i Docker
- 11 Namespaces a Kubernetes: clústers virtuals lògics
- 12 Funcionament pràctic de namespaces a Kubernetes
